
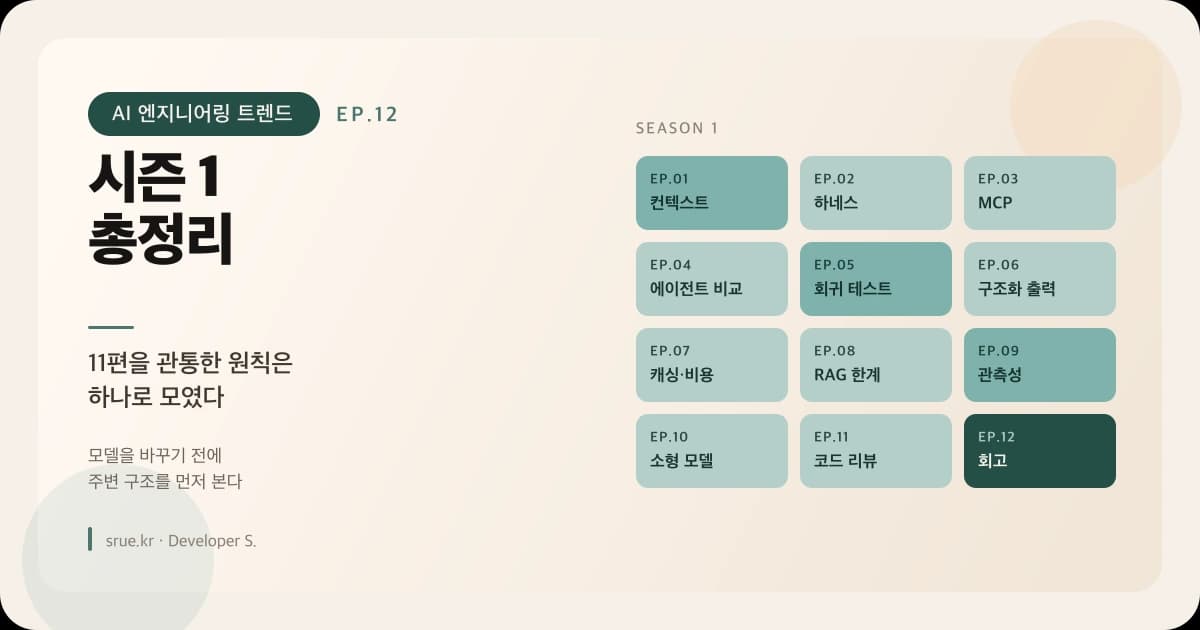
시즌 1 총정리: 11편을 관통한 원칙은 하나로 모였다
컨텍스트부터 코드 리뷰까지 11편을 쓰고 나니 같은 문장이 반복되고 있었습니다. AI 엔지니어링 트렌드 시즌 1을 관통한 원칙과 실무 도입 순서를 정리했습니다.
TL;DR
- 11편을 쓰는 동안 "모델을 바꾸기 전에 주변 구조를 먼저 본다"는 말을 계속 반복하고 있었습니다.
- 실제로 효과가 컸던 조치는 대부분 모델과 무관한 것이었습니다 — 순서 바꾸기, 개수 줄이기, 검증 단계 붙이기.
- 공통 패턴이 하나 더 있었습니다. 측정할 수 있으면 줄일 수 있고, 못 하면 못 줄입니다.
- 지금 시작한다면 테스트(EP.05)와 관측(EP.09)부터 붙이겠습니다. 나머지는 그 뒤에 순서대로 보입니다.
시즌 1을 시작할 때는 "AI 트렌드를 따라가자"는 생각이었습니다. 11편을 쓰고 나니 트렌드를 다룬 편이 거의 없었습니다. 대부분 옛날부터 하던 이야기 — 예산, 경계, 실패 처리, 테스트, 관측 — 를 LLM에 적용한 것이었습니다.
그게 결론이었습니다.
전체 목록
| EP | 제목 | 한 줄 |
|---|---|---|
| 01 | 컨텍스트 엔지니어링 | 컨텍스트 윈도는 용량이 아니라 예산 |
| 02 | 에이전트 하네스 설계 | 성능을 만드는 건 모델이 아니라 주변 구조 |
| 03 | MCP가 바꾸는 연동 비용 | 추상화는 대상이 많아질 때부터 값을 함 |
| 04 | 코딩 에이전트 고르기 | 갈리는 건 모델이 아니라 실행 루프 |
| 05 | LLM 회귀 테스트 | 1회 결과는 신호가 아니다. 통과율로 |
| 06 | 구조화 출력의 신뢰도 | 형식이 맞는 것과 사실이 맞는 건 다른 층위 |
| 07 | 프롬프트 캐싱과 비용 설계 | 같은 결과를 더 싸게 얻는 건 순서 문제 |
| 08 | 언제 RAG를 쓰지 말아야 하나 | 세어보지도 않고 정석을 따라갔었다 |
| 09 | 에이전트 관측성 | 안 보이면 못 고친다 |
| 10 | 작은 모델이 이기는 구간 | 전부 최고 모델은 설계가 아니라 방치 |
| 11 | AI 코드 리뷰 자동화 | 많이 찾는 것보다 안 틀리는 게 중요 |
반복된 원칙 1 — 모델이 아니라 주변 구조
편마다 문제는 달랐는데 해결책의 성격은 같았습니다.
| 편 | 문제 | 실제로 효과가 있었던 것 |
|---|---|---|
| 01 | 답변이 들쭉날쭉 | 검색 결과를 줄이고 걸러냄 |
| 02 | 엉뚱한 도구를 고름 | 도구 개수를 줄이고 설명을 고침 |
| 06 | 스키마대로 안 옴 | 중첩을 평평하게 |
| 07 | 비용이 큼 | 메시지 순서 재배치 |
| 10 | 비용·지연 | 작업별로 모델을 나눔 |
| 11 | 리뷰를 아무도 안 봄 | 검증 단계 추가 + 개수 상한 |
모델을 바꿔서 해결한 건 한 건도 없습니다. 전부 그 주변을 고친 것이었습니다.
이게 EP.02에서 "하네스"라는 말을 쓴 이유이고, 시즌 전체를 관통한 문장이 됐습니다.
모델은 도구 집합도, 권한 경계도, 실패 복구도, 작업 분리도 결정하지 않습니다. 전부 우리가 짭니다.
반복된 원칙 2 — 측정할 수 있으면 줄일 수 있다
두 번째 패턴은 더 늦게 알아챘습니다.
| 편 | 측정한 것 | 그래서 가능해진 일 |
|---|---|---|
| 01 | 구성 요소별 토큰 비중 | 도구 정의가 예상보다 무겁다는 발견 |
| 05 | 케이스별 통과율 | 프롬프트를 자신 있게 고치기 |
| 07 | 캐시 적중률 | 재배치 효과 확인 |
| 09 | 도구 호출 횟수 분포 | 루프에 빠진 요청 탐지 |
| 10 | 모델 교체 전후 통과율 | 비싼 모델을 내리는 결정 |
EP.10이 가장 분명한 사례입니다. 소형 모델로 내리는 건 누구나 떠올리지만, 아무도 안 합니다. 나빠질까 봐서요. 통과율을 잴 수 있으니 확인하고 내릴 수 있었습니다.
측정이 없으면 최적화는 도박이 되고, 도박이면 아무도 안 합니다. 그래서 비용은 계속 늘어납니다.
반복된 원칙 3 — 실패를 전제로 짠다
| 편 | 실패 전제 설계 |
|---|---|
| 02 | 되돌릴 수 없는 작업은 도구로 주지 않는다 |
| 02 | 일시적 오류는 코드가 재시도, 에이전트에게 안 올림 |
| 05 | 1회 실패로 판단하지 않고 통과율로 |
| 06 | 구조화 실패 시 평문 폴백 |
| 09 | 실패 재현을 위해 판정 근거를 남김 |
| 11 | 확신이 없으면 기각을 기본값으로 |
특히 EP.02의 결론을 여러 번 다시 썼습니다.
롤백을 잘 만드는 것보다 롤백할 일을 안 만드는 게 낫습니다.
지금 시작한다면 이 순서로
11편을 순서대로 쓰긴 했지만, 실무 도입 순서로는 이게 맞습니다.
| 순서 | 무엇 | 왜 먼저인가 |
|---|---|---|
| 1 | 회귀 테스트 | 없으면 이후 모든 변경이 도박 |
| 2 | 관측 | 없으면 무엇이 문제인지 모름 |
| 3 | 컨텍스트 정리 | 측정이 있으니 어디가 무거운지 보임 |
| 4 | 하네스 정리 | 도구·권한·실패 처리 |
| 5 | 비용 재배치 | 구조가 정리돼야 순서를 바꿀 수 있음 |
| 6 | 모델 분리 | 1번이 있어야 안전하게 내림 |
| 7 | 검색 방식 재검토 | 세어보고 결정 |
| 8 | MCP | 붙일 게 많아졌을 때 |
1·2번이 먼저인 게 핵심입니다. 저는 반대로 했습니다. 기능부터 만들고 테스트와 관측은 나중에 붙였고, 그래서 중간에 두 번 헤맸습니다.
쓰면서 바뀐 생각
시즌을 시작할 때와 달라진 것 세 가지입니다.
첫째, "AI 엔지니어링"이라는 말이 과했습니다. 새로운 공학이 아니라, 하던 공학을 비결정적 구성요소에 적용하는 일이었습니다. 예산 관리, 경계 설정, 실패 처리, 테스트, 관측 — 전부 원래 있던 것들입니다.
둘째, 모델 발표를 덜 쫓게 됐습니다. 새 모델이 나오면 좋아지긴 하지만, 제 문제의 대부분은 모델이 아니라 제가 짠 구조에 있었습니다. 그쪽이 개선 여지가 훨씬 컸습니다.
셋째, 줄이는 게 늘리는 것보다 효과적이었습니다. 도구를 줄이고, 검색 결과를 줄이고, 코멘트를 줄였을 때 결과가 좋아졌습니다. 더하는 방향으로만 생각하던 습관이 바뀌었습니다.
시즌 2 예고
시즌 1의 각 편은 조망이었습니다. 한 편에 담기에 큰 주제들이라 표면만 훑은 것도 있습니다.
시즌 2부터는 이 중 몇 개를 깊게 다룰 계획입니다. 어느 것을 먼저 할지는 이 글들의 반응을 보고 정하려 합니다. 후보는 이렇습니다.
- 컨텍스트 엔지니어링 심화 — 압축 손실, 윈도 배분, 멀티턴 전략
- 에이전트 하네스 패턴 — 권한 모델, 승인 흐름, 서브에이전트 구성
- LLM 테스트 파이프라인 구축 — 골든셋 관리, 판정기 설계, CI 통합
- MCP 서버 직접 만들기
읽으면서 "이건 더 자세히 봤으면" 싶었던 게 있다면 알려주세요. 거기부터 쓰겠습니다.
참고
시즌 1 전체는 AI 엔지니어링 트렌드 시리즈에서 순서대로 볼 수 있습니다.
이 시리즈와 이어지는 기존 글들: