
AI 코드 리뷰를 쓸 만하게 만들기: 오탐이 많으면 아무도 읽지 않는다
PR에 자동 리뷰를 붙였더니 처음엔 아무도 읽지 않았습니다. 찾는 단계보다 걸러내는 단계를 붙이고 개수를 제한하자 체감 품질이 달라진 과정을 정리했습니다.
TL;DR
- 자동 리뷰의 실패는 못 찾아서가 아니라 너무 많이 찾아서였습니다. 오탐이 섞이면 전부 무시됩니다.
- 해법은 더 좋은 모델이 아니라 찾은 뒤 걸러내는 단계를 붙이는 것이었습니다.
- 개수 상한을 두는 게 효과가 컸습니다. 20개를 다 주는 것보다 5개만 주는 편이 실제로 더 많이 고쳐집니다.
- AI가 잘하는 건 일관성 검사이고, 못하는 건 이 변경이 필요한 변경인가 판단입니다.
예전에 GitHub Actions로 PR 자동 리뷰를 붙였고, 리뷰 스킬을 직접 만들어 규칙을 정리했습니다.
붙이고 나서 몇 주 뒤, 팀에서 이런 말이 나왔습니다. "그거 이제 안 봐요."
이유는 명확했습니다. PR 하나에 코멘트가 열몇 개씩 달렸고, 그중 절반은 틀렸거나 무의미했습니다. 읽고 판단하는 시간이 직접 리뷰하는 시간보다 길어지면, 안 읽는 게 합리적입니다.
오탐이 섞이면 전부 무시된다
이게 가장 중요한 발견이었습니다. 정확도가 70%면 70%만큼 쓸모 있는 게 아닙니다. 0에 가까워집니다.
| 상황 | 사람의 행동 |
|---|---|
| 10개 중 10개가 맞음 | 전부 읽고 고침 |
| 10개 중 8개가 맞음 | 읽긴 하는데 매번 의심 |
| 10개 중 5개가 맞음 | 읽지 않음 |
| 3개인데 3개 다 맞음 | 전부 읽고 고침 |
마지막 줄이 핵심입니다. 개수가 적어도 신뢰할 수 있으면 실제로 고쳐집니다. 많이 찾는 것보다 틀리지 않는 게 중요했습니다.
그래서 목표를 바꿨습니다. "최대한 많이 찾기"에서 "틀린 걸 내보내지 않기"로.
범위부터 좁힌다
첫 번째 조치는 리뷰 대상을 줄이는 것이었습니다.
| 제외 | 이유 |
|---|---|
| 변경되지 않은 파일 | 이번 PR의 책임이 아님 |
| 자동 생성 파일 · 잠금 파일 | 사람이 고칠 대상이 아님 |
| 포맷팅만 바뀐 줄 | 린터의 일 |
| 테스트 픽스처 데이터 | 규칙이 다름 |
| 대량 이동·이름 변경 | diff가 의미를 못 담음 |
린터가 잡는 건 AI에게 시키지 않습니다. 들여쓰기, 네이밍 컨벤션, import 순서 같은 건 이미 정적 분석 도구가 더 정확하고 더 싸게 잡습니다. 겹치면 소음만 늘어납니다.
AI에게는 도구가 못 잡는 것만 남깁니다.
찾기와 거르기를 분리한다
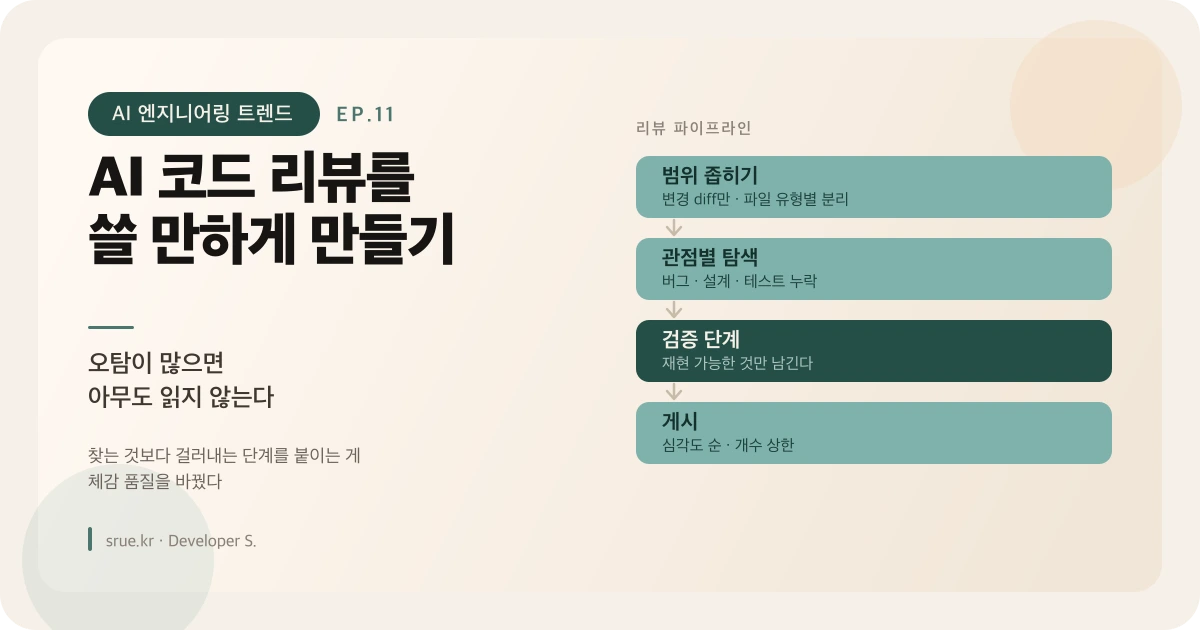
핵심 변경입니다. 한 번에 끝내지 않고 두 단계로 나눴습니다.
1단계  탐색     관점별로 넓게 찾는다 (버그 · 설계 · 테스트 누락)
                 → 여기서는 많이 나와도 된다
2단계  검증     각 지적을 따로 검증한다
                 → "이게 실제로 재현되는가?"
3단계  게시     살아남은 것만, 심각도 순으로, 개수 제한
2단계가 전부입니다. 1단계에서 나온 지적 하나하나에 대해 "반박해 보라"고 따로 물어봅니다.
이 지적이 실제로 문제인지 검증하세요.
· 문제가 재현되는 구체적 입력·상태를 제시할 수 있습니까?
· 제시할 수 없으면 기각하세요.
· 확신이 서지 않으면 기각하세요.
· 코드베이스의 다른 곳에서 이미 처리하고 있지는 않습니까?"확신이 서지 않으면 기각"이 결정적이었습니다. 기본값을 통과가 아니라 기각으로 두니, 애매한 지적이 대부분 걸러졌습니다.
검증은 탐색과 별개 호출로 돌립니다. 같은 대화 안에서 "다시 확인해봐"라고 하면 자기가 쓴 걸 방어하는 경향이 있었습니다. 문맥을 끊고 지적만 던지니 훨씬 냉정하게 판단했습니다.
개수 상한을 둔다
검증을 통과한 것도 전부 달지 않습니다.
| 규칙 | 값 |
|---|---|
| PR당 최대 코멘트 | 5개 |
| 정렬 | 심각도 순 |
| 같은 파일 연속 지적 | 최대 2개 |
| 심각도 하 | 요약에만, 개별 코멘트 없음 |
처음엔 "찾은 걸 왜 버리나" 싶었는데, 결과가 반대였습니다. 5개만 줬을 때 고쳐진 개수가 20개를 줬을 때보다 많았습니다. 20개는 압도되어 아무것도 안 하게 되고, 5개는 다 보게 됩니다.
EP.02에서 도구 개수를 줄인 것과 같은 구조입니다. 많을수록 좋은 게 아니었습니다.
AI가 잘하는 것과 못하는 것
몇 달 돌려보고 구분이 생겼습니다.
| 잘함 | 못함 |
|---|---|
| 일관성 검사 — 같은 상황을 다르게 처리한 곳 | 이 변경이 필요한가 판단 |
| 예외 처리 누락 | 성능 문제의 실제 영향도 |
| 테스트 누락 — 분기는 늘었는데 테스트는 안 늘어남 | 팀 관례·역사적 맥락 |
| 경계 조건 | 아키텍처 방향 |
| 문서와 코드 불일치 | 우선순위 |
일관성 검사가 압도적으로 유용했습니다. "이 프로젝트의 다른 컨트롤러는 전부 ProblemDetail을 쓰는데 여기만 커스텀 포맷입니다" 같은 지적은 사람이 놓치기 쉽고 AI가 잘 찾습니다. 에러 응답을 표준화하던 시기에 특히 값을 했습니다.
반대로 "이 기능이 필요한가"는 절대 못 맡깁니다. 그건 리뷰의 본질인데, 코드만 봐서는 알 수 없는 영역입니다.
사람 리뷰와의 역할 분담
결국 이렇게 정리됐습니다.
AI 리뷰 (PR 열리면 자동)
  일관성 · 누락 · 경계 조건
  → 사람이 리뷰하기 전에 기계적인 것들을 치워둔다

사람 리뷰
  이게 필요한 변경인가
  이 방향이 맞는가
  나중에 이걸 유지보수할 수 있는가
AI 리뷰는 사람 리뷰를 대체하는 게 아니라 앞단을 치우는 역할입니다. 기계적인 지적이 먼저 정리되면, 사람은 판단이 필요한 것에 집중할 수 있습니다.
에이전트 시대의 개발자 역할에서 쓴 것과 이어집니다 — 남는 건 맥락과 판단입니다.
정리
| 문제 | 해법 |
|---|---|
| 오탐이 섞여 전부 무시됨 | 검증 단계 분리. 기본값을 기각으로 |
| 코멘트가 너무 많음 | PR당 5개 상한 |
| 린터와 겹침 | 도구가 잡는 건 제외 |
| 자기 지적을 방어함 | 검증을 별개 호출로 |
| 필요한 변경인지 판단 못 함 | 그건 사람 몫으로 남김 |
시작할 때는 "얼마나 잘 찾나"를 봤는데, 지금은 "얼마나 안 틀리나"를 봅니다. 리뷰는 신뢰가 없으면 존재 의미가 없는 도구였습니다.
다음 편
여기까지가 시즌 1의 마지막 실무 편입니다. 11편을 쓰면서 같은 말을 반복하고 있다는 걸 알게 됐는데, 그게 우연이 아니었습니다.
다음 편에서는 시즌 1을 관통한 원칙을 정리합니다.