
프롬프트 캐싱과 비용 설계: 같은 결과를 더 싸게 얻는 건 순서 문제였다
LLM 호출 비용이 예상보다 컸는데 원인은 모델이 아니라 프롬프트 구성 순서였습니다. 고정 블록을 앞으로 모아 캐시를 살리고, 무엇이 캐시를 깨뜨리는지 정리했습니다.
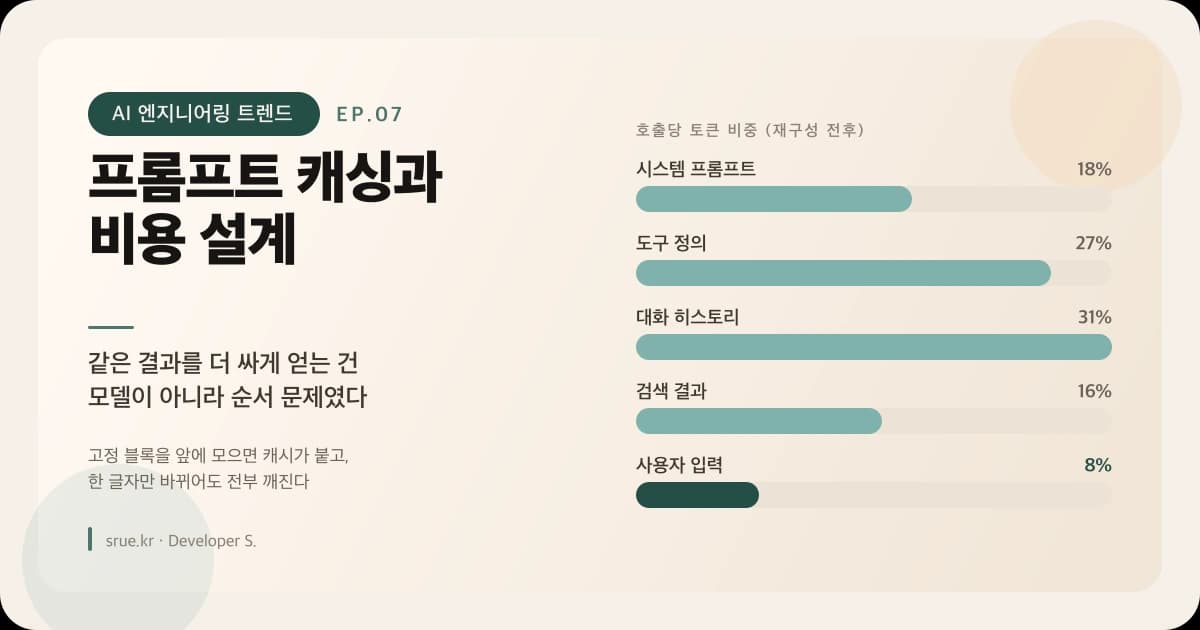
TL;DR
- 프롬프트 캐싱은 접두사(prefix) 단위로 걸립니다. 앞에서 한 글자만 달라져도 뒤 전체가 캐시를 못 씁니다.
- 그래서 고정된 것을 앞에, 변하는 것을 뒤에 두는 배치만으로 비용이 크게 달라집니다.
- 가장 흔한 실수는 시스템 프롬프트에 타임스탬프나 사용자 이름을 넣는 것입니다. 매 호출 캐시가 깨집니다.
- 비용은 "총액"이 아니라 "요청 유형별 단가"로 봐야 줄일 곳이 보입니다.
구조화 출력을 정리하면서 재시도 경로를 만들었더니, 실패할 때마다 호출이 두 번씩 나갔습니다. 그 김에 청구서를 열어봤는데 예상보다 컸습니다.
처음엔 "더 싼 모델로 바꿀까" 생각했습니다. 그런데 EP.01에서 만들어 둔 토큰 계측을 다시 보니 다른 게 보였습니다. 매 호출마다 거의 같은 내용이 반복해서 실려 나가고 있었습니다.
캐싱은 접두사 단위로 걸린다
프롬프트 캐싱의 동작을 오해하고 있었습니다. "비슷한 요청을 캐시한다"고 생각했는데 아니었습니다.
프롬프트의 앞에서부터 얼마나 같은지를 봅니다. 같은 구간까지만 캐시가 적용되고, 처음 달라지는 지점부터는 전부 새로 계산합니다.
호출 A:  [시스템][도구 정의][대화 이력][질문 1]
호출 B:  [시스템][도구 정의][대화 이력][질문 2]
                                      ↑ 여기까지 캐시 적중

호출 C:  [시스템 + 현재시각][도구 정의][대화 이력][질문 3]
          ↑ 여기서 이미 깨짐 → 전부 새로 계산
호출 C가 제 상황이었습니다. 시스템 프롬프트에 현재 시각: 2026-09-27 14:32:07을 넣어뒀는데, 매 호출마다 달라지니 캐시가 한 번도 안 걸렸습니다.
캐시를 깨뜨리는 것들
찾아보니 여러 군데 있었습니다.
| 위치 | 내용 | 결과 |
|---|---|---|
| 시스템 프롬프트 | 현재 시각 | 매 호출 전부 깨짐 |
| 시스템 프롬프트 | 사용자 이름·ID | 사용자별로 캐시 분리 |
| 도구 정의 | 동적 등록 순서가 매번 다름 | 순서만 바뀌어도 다른 문자열 |
| 도구 정의 | 설명에 잔여 크레딧 등 변동값 | 매번 깨짐 |
| 대화 이력 | 앞쪽 턴을 요약으로 교체 | 교체 시점에 전체 무효화 |
도구 정의 순서가 의외의 함정이었습니다. EP.02에서 요청 유형별로 도구를 동적 등록하도록 바꿨는데, 등록 순서가 Set 순회 순서를 따라 매번 달라졌습니다. 내용이 같아도 순서가 다르면 다른 문자열이라 캐시가 안 걸렸습니다. 이름순 정렬 한 줄로 해결됐습니다.
재배치 — 고정된 것을 앞으로
원칙은 단순합니다. 변하지 않는 것부터 순서대로.
1. 시스템 프롬프트     ← 완전 고정. 변동값 금지
2. 도구 정의           ← 정렬 고정. 요청 유형별로 묶음
3. 참조 문서·예시      ← 자주 안 바뀜
4. 대화 이력           ← 뒤로 갈수록 자주 바뀜
5. 동적 컨텍스트       ← 현재 시각, 사용자 정보
6. 사용자 입력         ← 매번 다름
5번이 핵심입니다. 현재 시각이 필요 없다는 게 아니라, 시스템 프롬프트가 아니라 여기 있어야 한다는 뜻입니다. 위치만 옮겨도 앞의 1~4가 전부 캐시에 걸립니다.
Spring AI에서는 메시지 구성 순서를 이렇게 고정했습니다.
public Prompt build(AgentRequest request) {
    List<Message> messages = new ArrayList<>();

    messages.add(new SystemMessage(staticSystemPrompt));        // 고정
    messages.addAll(toolDefinitions(request.intent()));          // 이름순 정렬
    messages.addAll(referenceDocuments(request.intent()));       // 자주 안 바뀜
    messages.addAll(conversationHistory(request.sessionId()));   // 뒤쪽만 변동

    // 변동값은 사용자 입력 바로 앞에만 둔다. 여기서 캐시가 끊겨야 한다.
    messages.add(new UserMessage(dynamicContext(request)));
    messages.add(new UserMessage(request.text()));

    return new Prompt(messages);
}
주석에 적은 "여기서 캐시가 끊겨야 한다"가 이 코드의 전부입니다. 끊기는 지점을 최대한 뒤로 미는 게 목표입니다.
대화 이력의 딜레마
한 가지 풀기 어려운 게 남았습니다.
EP.01에서 대화 이력을 중간 요약으로 압축했는데, 요약이 실행되는 순간 그 지점부터 캐시가 전부 무효화됩니다. 자리를 아끼려는 최적화가 비용 최적화를 깨뜨리는 셈입니다.
| 방식 | 자리 | 캐시 |
|---|---|---|
| 이력 전부 유지 | ❌ 계속 늘어남 | ✅ 앞부분 계속 적중 |
| 매 턴 재요약 | ✅ 일정 | ❌ 매 턴 무효화 |
| N턴마다 한 번만 요약 | 🟡 톱니 모양 | 🟡 요약 시점만 무효화 |
세 번째로 갔습니다. 매 턴 요약하는 대신 정해진 턴 수마다 한 번씩 압축합니다. 자리는 톱니처럼 오르내리지만, 캐시는 압축 직후 한 번만 깨집니다.
완벽한 답은 아니고 균형점입니다. 대화가 짧은 서비스라면 압축을 아예 안 하는 게 나을 수도 있습니다.
비용은 총액이 아니라 단가로 본다
청구서 총액만 보면 줄일 곳이 안 보입니다. 요청 유형별로 나눠 봐야 합니다.
EP.01의 토큰 계측 어드바이저에 필드를 몇 개 더 붙였습니다.
| 지표 | 왜 보는가 |
|---|---|
| 요청 유형별 평균 입력 토큰 | 어떤 유형이 무거운가 |
| 캐시 적중률 | 재배치 효과 측정 |
| 재시도로 인한 추가 호출 비율 | 실패가 비용으로 새는 정도 |
| 요청 유형별 호출 건수 | 싼 요청이 많은가, 비싼 요청이 많은가 |
| 도구 호출 횟수 분포 | 루프에 빠진 케이스 탐지 |
이걸 Actuator 메트릭으로 노출해서 대시보드에 올렸습니다. 가장 비싼 요청 유형이 가장 드물게 쓰이는 기능이었다는 게 드러났습니다. 총액만 봤으면 몰랐을 일입니다.
줄일 수 있는 순서
효과 대비 노력 순으로 정리하면 이렇습니다.
| 순서 | 조치 | 노력 |
|---|---|---|
| 1 | 시스템 프롬프트에서 변동값 제거 | 매우 낮음 |
| 2 | 도구 정의 정렬 고정 | 매우 낮음 |
| 3 | 고정 → 변동 순으로 메시지 재배치 | 낮음 |
| 4 | 안 쓰는 도구 제거 | 낮음 |
| 5 | 요약 주기 조정 | 중간 |
| 6 | 요청 유형별 모델 분리 | 중간 |
| 7 | 배치 처리로 전환 (실시간 불필요한 작업) | 높음 |
1·2번이 거의 공짜인데 효과가 가장 컸습니다. 한 줄씩 고치는 일인데 캐시 적중률이 0에서 유의미하게 올라갔습니다. 모델을 바꾸기 전에 이것부터 볼 일입니다.
정리
- 캐싱은 접두사 단위다. 앞에서 깨지면 뒤 전체가 손해다
- 시스템 프롬프트에 시각·사용자 정보를 넣지 않는다
- 도구 정의는 순서를 고정한다. 내용이 같아도 순서가 다르면 다른 문자열이다
- 변동값은 사용자 입력 바로 앞에 둔다
- 비용은 요청 유형별 단가로 본다
EP.01에서 컨텍스트를 예산으로 봤다면, 이번엔 그 예산의 단가를 본 셈입니다. 같은 토큰이라도 캐시에 걸리면 값이 다릅니다.
다음 편
비용을 줄이려 검색 결과를 손보다가 근본적인 의문이 들었습니다. 이 기능에 RAG가 꼭 필요한가?
다음 편에서는 언제 RAG를 쓰지 말아야 하는가를 다룹니다.