세상에 필요한 서비스를 만들고
쉽고 편리한 경험에 가치를 더합니다.
복잡한 문제를 단순하게 풀고, 오래 남는 사용자 경험을 고민합니다. Spring·Java 서버를 운영하며 겪은 문제와 AI 도구를 실무에 넣는 과정을 이곳에 기록합니다.
About
재밌는걸 평생 만들고 싶어요.
“
기술적 부채(Tech Debt)보다 무서운 것은 '창의적 부채'다.
AI가 다 해줄 때, 당신의 독창성은 어디에 있는가?
”
Tech
기술 블로그
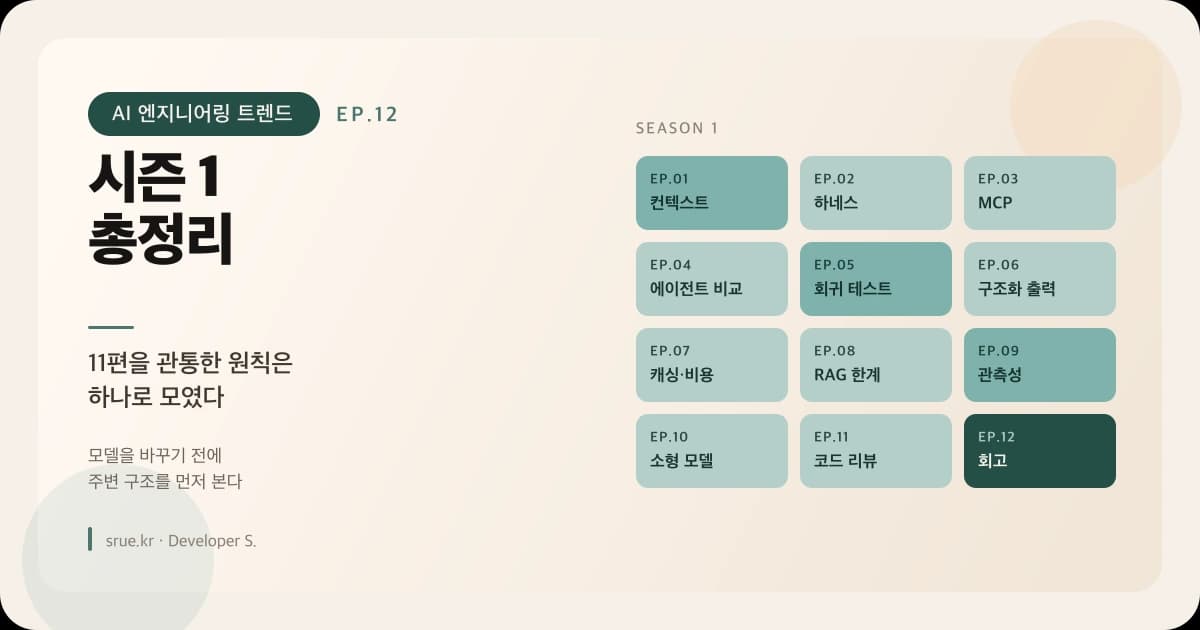
시즌 1 총정리: 11편을 관통한 원칙은 하나로 모였다
컨텍스트부터 코드 리뷰까지 11편을 쓰고 나니 같은 문장이 반복되고 있었습니다. AI 엔지니어링 트렌드 시즌 1을 관통한 원칙과 실무 도입 순서를 정리했습니다.
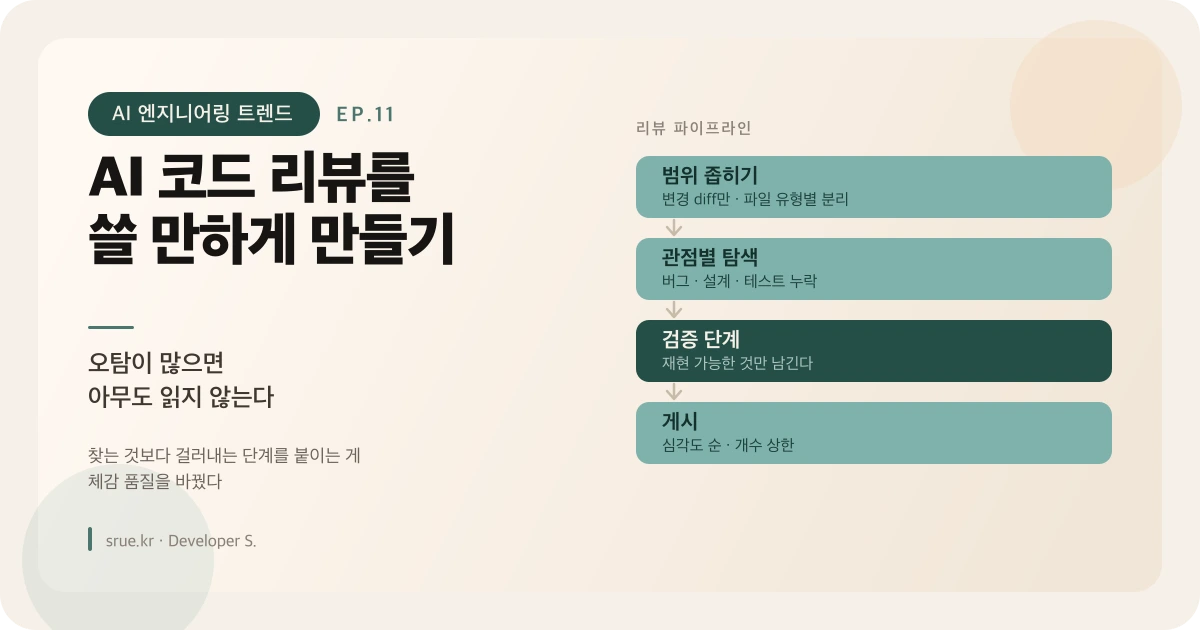
AI 코드 리뷰를 쓸 만하게 만들기: 오탐이 많으면 아무도 읽지 않는다
PR에 자동 리뷰를 붙였더니 처음엔 아무도 읽지 않았습니다. 찾는 단계보다 걸러내는 단계를 붙이고 개수를 제한하자 체감 품질이 달라진 과정을 정리했습니다.
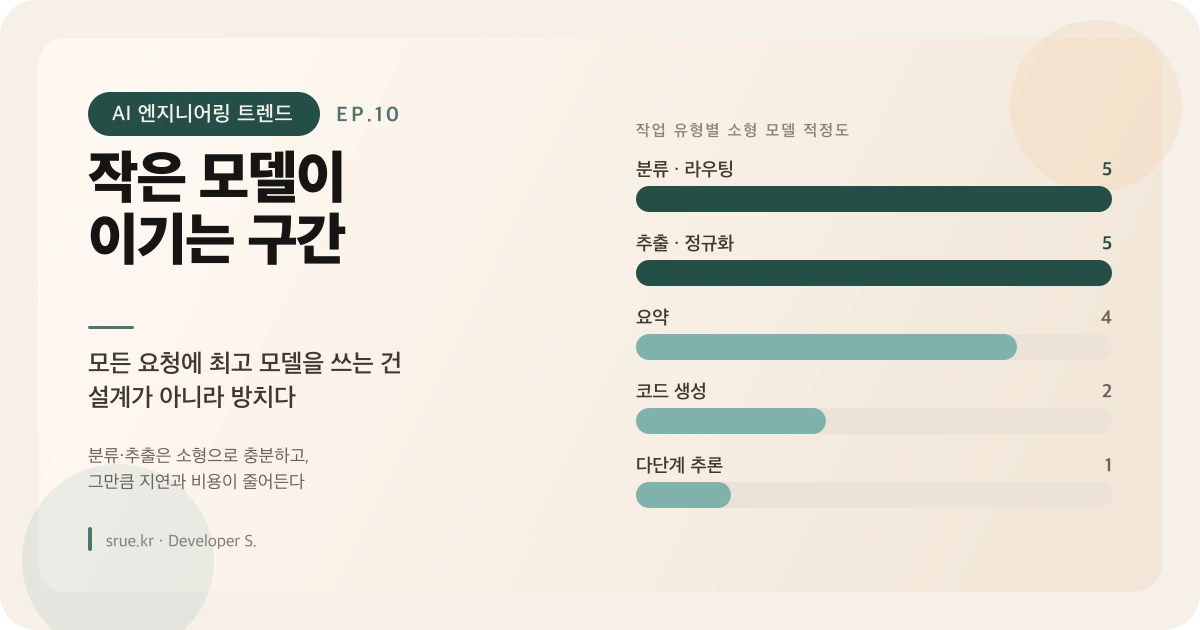
작은 모델이 이기는 구간: 모든 요청에 최고 모델을 쓰는 건 설계가 아니다
관측 지표를 보니 분류와 추출 같은 단순 작업에까지 가장 비싼 모델이 쓰이고 있었습니다. 작업 유형별로 모델을 나누고 라우팅을 붙인 과정을 정리했습니다.
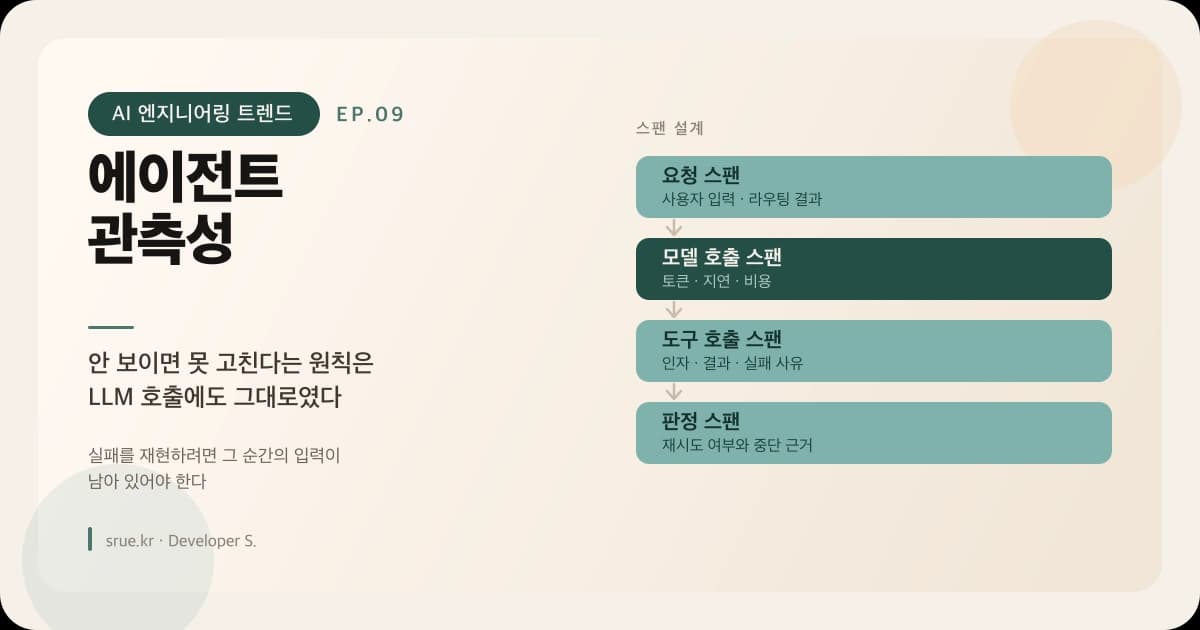
에이전트 관측성: 안 보이면 못 고친다는 원칙은 LLM 호출에도 그대로였다
에이전트가 왜 그렇게 답했는지 되짚을 수 없어 매번 추측으로 고쳤습니다. 스팬을 어떻게 나누고 무엇을 남겨야 실패를 재현할 수 있는지 정리했습니다.
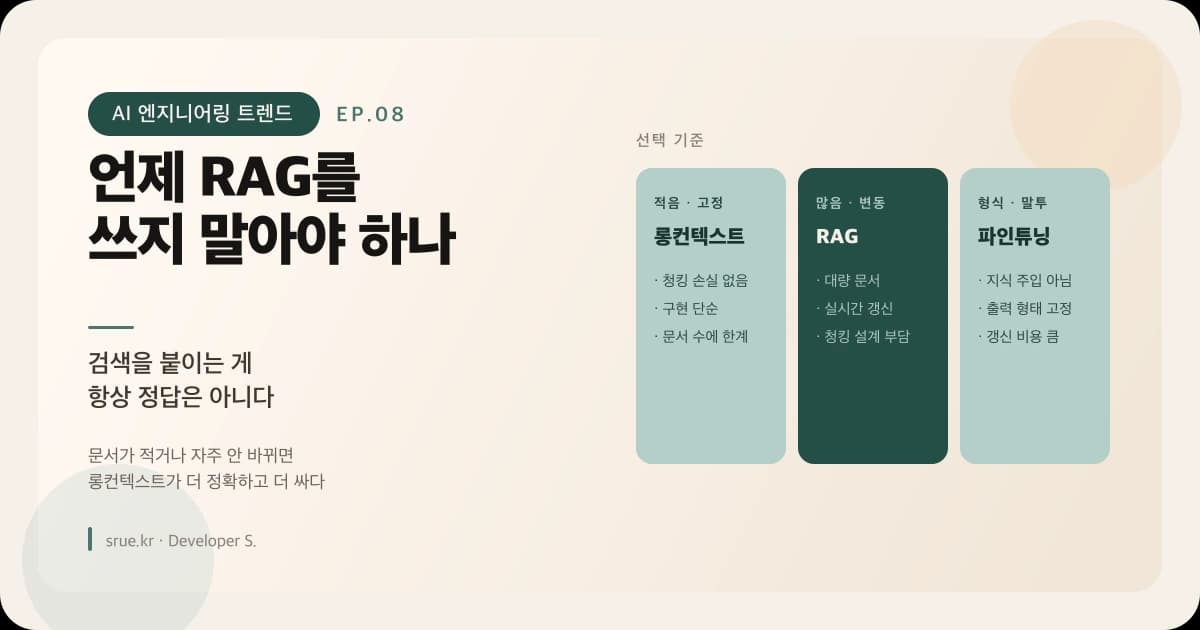
언제 RAG를 쓰지 말아야 하나: 검색을 붙이는 게 항상 정답은 아니다
RAG 파이프라인을 걷어내고 롱컨텍스트로 바꿨더니 더 정확해진 기능이 있었습니다. 문서 수·변경 빈도·질문 유형으로 RAG와 대안을 가르는 기준을 정리했습니다.
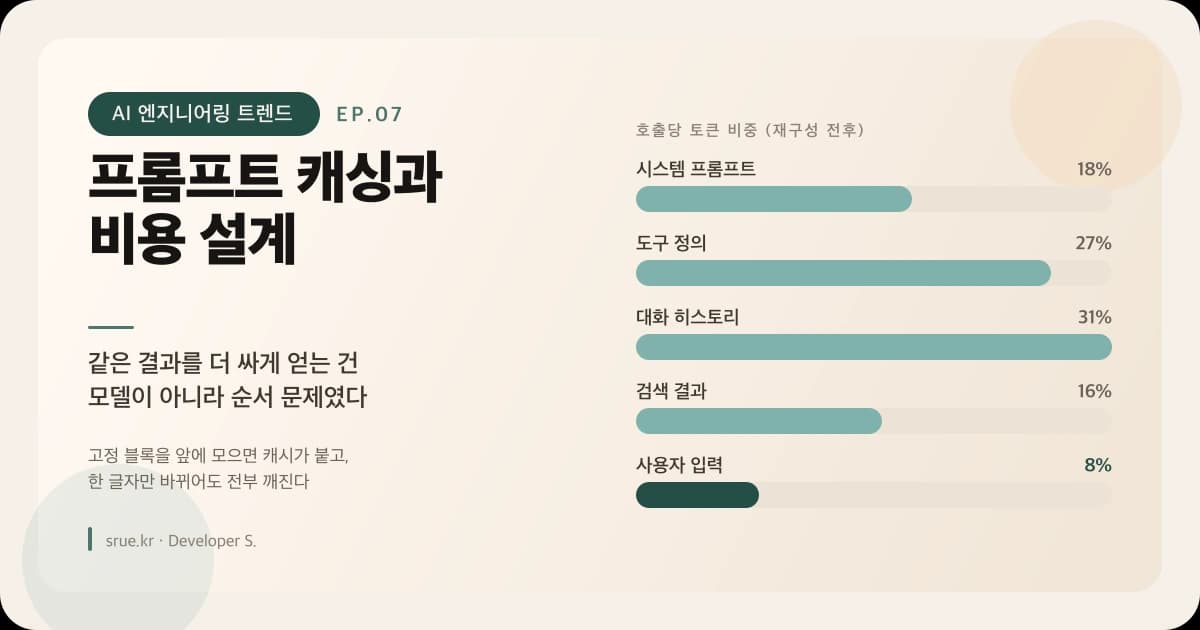
프롬프트 캐싱과 비용 설계: 같은 결과를 더 싸게 얻는 건 순서 문제였다
LLM 호출 비용이 예상보다 컸는데 원인은 모델이 아니라 프롬프트 구성 순서였습니다. 고정 블록을 앞으로 모아 캐시를 살리고, 무엇이 캐시를 깨뜨리는지 정리했습니다.
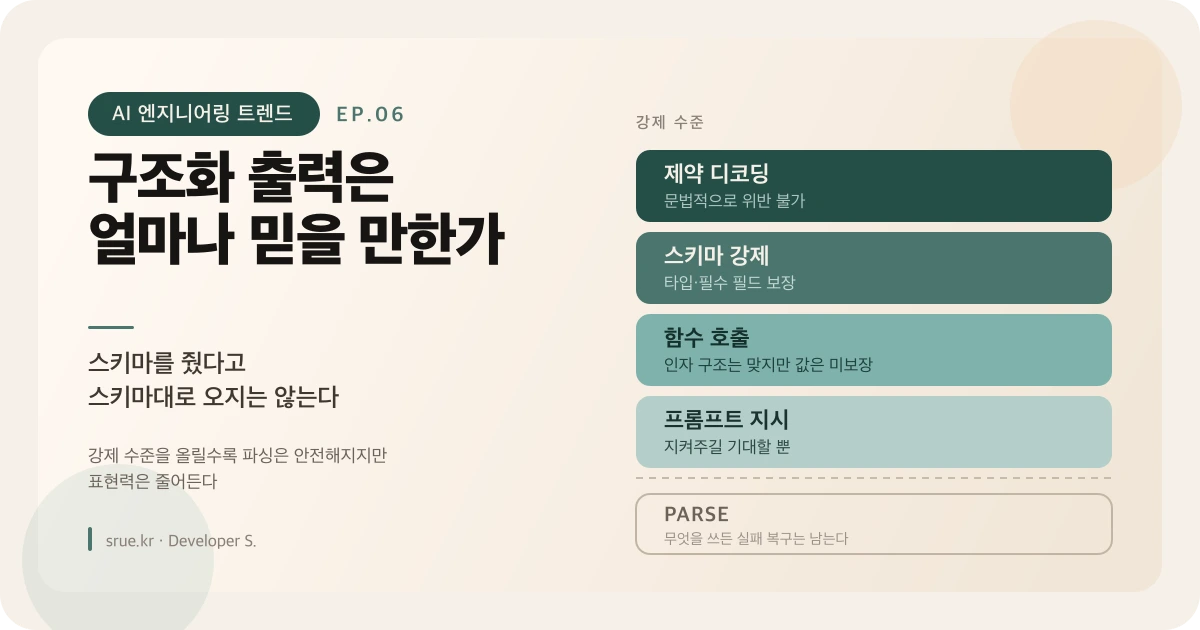
구조화 출력은 얼마나 믿을 만한가: 스키마를 줬다고 스키마대로 오지는 않는다
JSON 스키마를 넘기면 끝날 줄 알았는데 아니었습니다. 프롬프트 지시부터 제약 디코딩까지 강제 수준을 네 단계로 나누고, 각 단계에서 무엇이 보장되고 무엇이 안 되는지 정리했습니다.
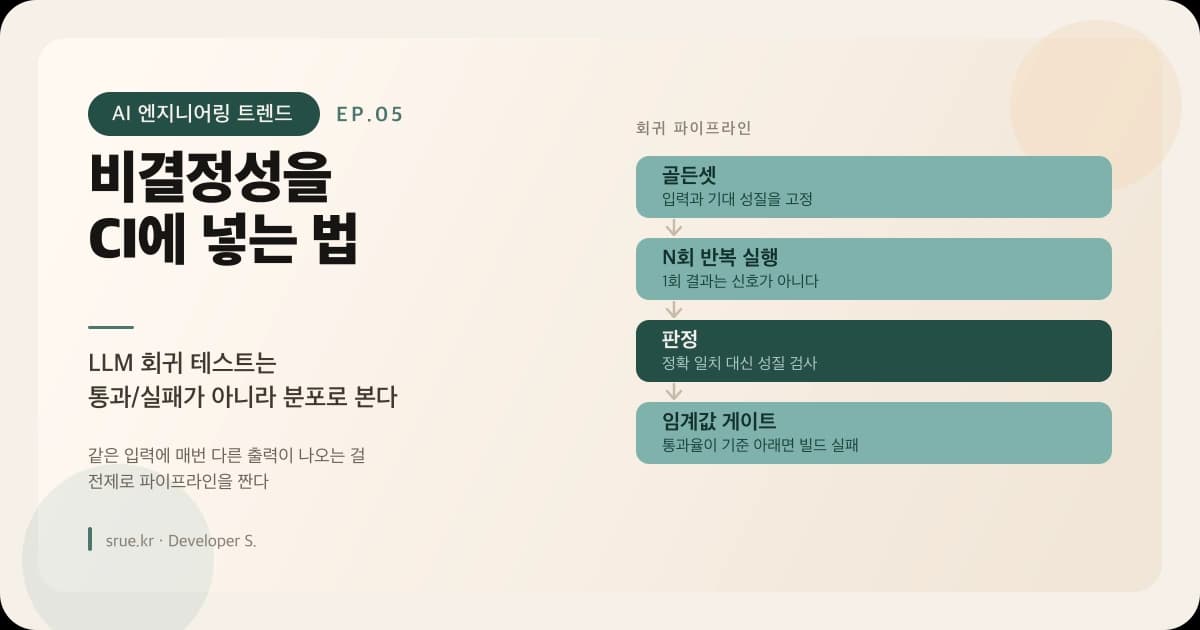
LLM 회귀 테스트를 CI에 넣기: 매번 다른 출력을 어떻게 통과/실패로 가를까
같은 입력에 매번 다른 답이 나오는 걸 전제로 테스트를 짰습니다. 정확 일치 대신 성질 검사, 1회 실행 대신 통과율 임계값으로 CI 게이트를 만든 과정을 정리했습니다.
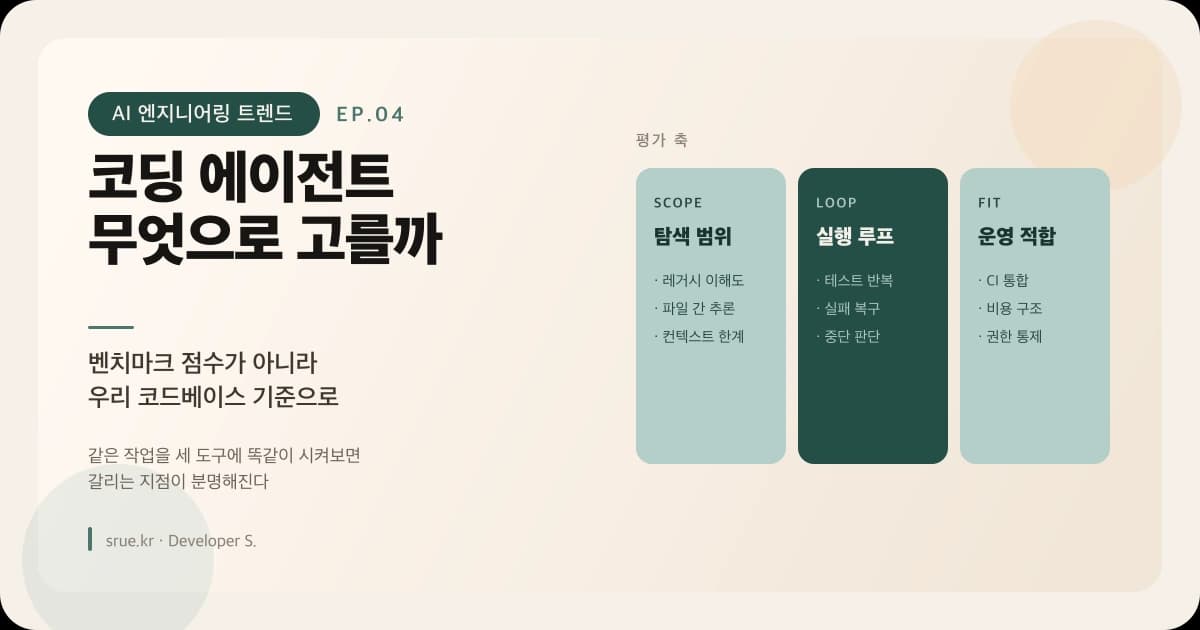
코딩 에이전트, 벤치마크 말고 우리 코드베이스 기준으로 고르기
여러 코딩 에이전트를 실제 작업에 번갈아 쓰면서 갈리는 지점이 분명해졌습니다. 탐색 범위·실행 루프·운영 적합성 세 축으로 판단 기준을 정리했습니다.