
언제 RAG를 쓰지 말아야 하나: 검색을 붙이는 게 항상 정답은 아니다
RAG 파이프라인을 걷어내고 롱컨텍스트로 바꿨더니 더 정확해진 기능이 있었습니다. 문서 수·변경 빈도·질문 유형으로 RAG와 대안을 가르는 기준을 정리했습니다.
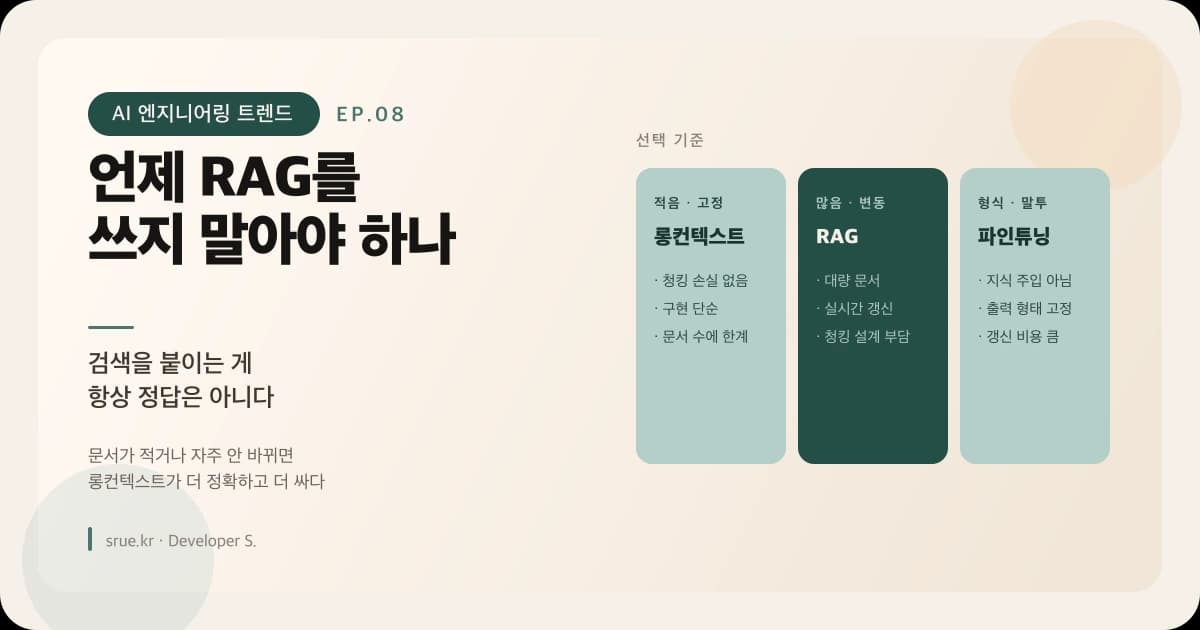
TL;DR
- 문서가 적고 자주 안 바뀌면 RAG보다 롱컨텍스트가 정확하고 단순합니다. 청킹 손실이 없기 때문입니다.
- RAG가 자주 실패하는 지점은 검색이 아니라 청킹입니다. 답이 두 청크에 걸쳐 있으면 못 찾습니다.
- "전체를 봐야 답할 수 있는 질문"에는 RAG가 구조적으로 불리합니다. 개수를 세거나 비교하는 질문이 그렇습니다.
- 파인튜닝은 RAG의 대안이 아닙니다. 지식 주입이 아니라 형식·말투 고정에 씁니다.
비용을 정리하면서 검색 결과가 차지하는 자리를 들여다보다 의문이 생겼습니다. 이 기능에 RAG가 정말 필요한가?
대상 문서를 세어봤습니다. 사내 정책 문서 열몇 개였습니다. 전부 합쳐도 컨텍스트 윈도에 넉넉히 들어가는 양이었습니다.
그런데 저는 pgvector로 임베딩을 만들고 벡터 검색을 붙여 놓고 있었습니다. 왜 그랬는지 생각해보니, RAG가 정석이라고 여겨서였습니다.
RAG가 실패하는 진짜 지점
걷어내기 전에 어디서 틀리는지 먼저 봤습니다. 예상과 달랐습니다.
| 실패 유형 | 원인 | 검색을 개선하면 해결되나 |
|---|---|---|
| 답이 두 청크에 걸침 | 청킹 | ❌ |
| 표의 헤더와 행이 분리됨 | 청킹 | ❌ |
| "총 몇 개인가" 류 질문 | 부분만 가져오는 구조 | ❌ |
| 문서 간 비교 질문 | top-k 안에 둘 다 못 들어옴 | 🟡 부분적 |
| 동의어 때문에 못 찾음 | 검색 | ✅ |
| 관련 없는 청크가 섞임 | 검색 | ✅ |
위 세 개는 검색을 아무리 개선해도 안 됩니다. 임베딩 모델을 바꾸고 재순위를 붙여도 그대로였습니다. 구조에서 오는 한계였습니다.
특히 표가 문제였습니다. 정책 문서의 요금표가 청크 경계에서 잘리면, 헤더 없는 숫자 나열만 검색돼 옵니다. 모델은 그 숫자가 무엇인지 모른 채 답합니다.
롱컨텍스트로 바꿔봤다
문서가 적으니 전부 넣어봤습니다. 검색 단계를 통째로 뺐습니다.
| RAG | 롱컨텍스트 | |
|---|---|---|
| 청킹 손실 | 있음 | 없음 |
| 표·구조 보존 | 깨짐 | 유지 |
| 전체 조망 질문 | 불가 | 가능 |
| 구현 복잡도 | 임베딩·벡터DB·재순위 | 문서를 붙이면 끝 |
| 문서 수 한계 | 사실상 없음 | 윈도 크기까지 |
| 호출 비용 | 낮음 | 높음 — 단, 캐싱이 걸림 |
| 갱신 | 증분 색인 | 전체 교체 |
비용이 걱정이었는데 캐싱이 해결했습니다. 문서 블록은 고정이라 프롬프트 앞쪽에 두면 캐시에 걸립니다. EP.07에서 재배치를 해둔 덕을 여기서 봤습니다.
정확도는 눈에 띄게 좋아졌습니다. 특히 표 관련 질문과 "이 정책과 저 정책의 차이" 같은 비교 질문에서요. 청킹으로 잃던 것이 그만큼 컸다는 뜻입니다.
그래서 기준을 이렇게 잡았다
전부 롱컨텍스트로 바꾸자는 얘기가 아닙니다. 문서가 늘면 결국 RAG가 필요합니다. 판단 기준을 정리했습니다.
| 조건 | 선택 |
|---|---|
| 문서가 적고 · 자주 안 바뀜 | 롱컨텍스트 |
| 문서가 많음 (윈도에 안 들어감) | RAG |
| 실시간으로 계속 추가됨 | RAG |
| 전체를 봐야 답하는 질문이 많음 | 롱컨텍스트 (또는 사전 집계) |
| 사용자마다 볼 수 있는 문서가 다름 | RAG (권한 필터가 검색 단계에 필요) |
| 출력 형식·말투를 고정하고 싶음 | 파인튜닝 (RAG의 대안이 아님) |
"사용자마다 권한이 다름"은 롱컨텍스트로 풀기 어렵습니다. 전부 넣으면 볼 수 없는 문서까지 모델이 보게 되니까요. 이건 RAG를 써야 할 분명한 이유입니다.
중간 선택지 — 둘을 섞기
실제로 가장 잘 맞았던 건 양자택일이 아니라 2단계 구조였습니다.
1단계  문서 단위 라우팅   "이 질문은 어느 문서(들)에 관한 것인가"
2단계  선택된 문서를 통째로 컨텍스트에
청크가 아니라 문서 단위로 고릅니다. 그러면 청킹 손실 없이 문서 수 제약도 완화됩니다. 문서 제목과 한 줄 요약만으로 라우팅하니 1단계는 싸고 빠릅니다.
| 청크 RAG | 문서 라우팅 | 전체 롱컨텍스트 | |
|---|---|---|---|
| 손실 | 청킹에서 발생 | 없음 | 없음 |
| 문서 수 | 제한 없음 | 수십~수백 | 열몇 개 |
| 전체 조망 | ❌ | 🟡 선택된 것 안에서 | ✅ |
| 캐시 | 매번 다름 | 문서 조합별 | ✅ 완전 고정 |
문서가 수십 개 수준이면 이 방식이 가장 균형이 좋았습니다.
파인튜닝은 다른 축이다
"RAG냐 파인튜닝이냐"로 묶어 말하는 걸 자주 보는데, 둘은 푸는 문제가 다릅니다.
| 해결하는 것 | 해결 못 하는 것 | |
|---|---|---|
| RAG · 롱컨텍스트 | 지식 주입 — 모델이 모르는 사실 | 말투·형식 |
| 파인튜닝 | 형식·말투·판단 기준 | 지식 갱신 |
파인튜닝으로 사내 정책을 외우게 하려는 시도는 대체로 나쁜 선택입니다. 정책이 바뀌면 다시 학습해야 하고, 무엇을 외웠는지 확인할 방법이 없습니다. EP.06에서 본 것처럼 형식이 맞는 그럴듯한 오답이 나오는데, 근거를 댈 수 없습니다.
반대로 출력 형식이 항상 같아야 한다면 파인튜닝이 프롬프트보다 안정적입니다. 지식이 아니라 형태를 고정하는 용도입니다.
되돌아보면
제가 RAG를 붙인 이유는 필요해서가 아니라 그게 표준 해법처럼 보여서였습니다. 문서를 세어보지도 않고 시작했습니다.
EP.03에서 MCP를 두고 내린 결론과 같습니다 — 추상화는 대상이 많아졌을 때부터 값을 합니다. 문서 열몇 개에 벡터 검색을 얹는 건 시스템 하나에 프로토콜을 얹는 것과 비슷한 과잉이었습니다.
먼저 세어보는 게 먼저입니다.
문서 몇 개인가?
전부 합치면 몇 토큰인가?
얼마나 자주 바뀌는가?
사용자마다 볼 수 있는 게 다른가?
이 네 줄이면 대부분 결정됩니다.
다음 편
RAG를 걷어내고 구조를 바꾸는 동안, 무엇이 좋아졌는지 확인할 방법이 부실하다는 걸 계속 느꼈습니다. 실패를 재현하려 해도 그 순간의 입력이 남아 있지 않았습니다.
다음 편에서는 에이전트 관측성을 다룹니다.