
LLM 회귀 테스트를 CI에 넣기: 매번 다른 출력을 어떻게 통과/실패로 가를까
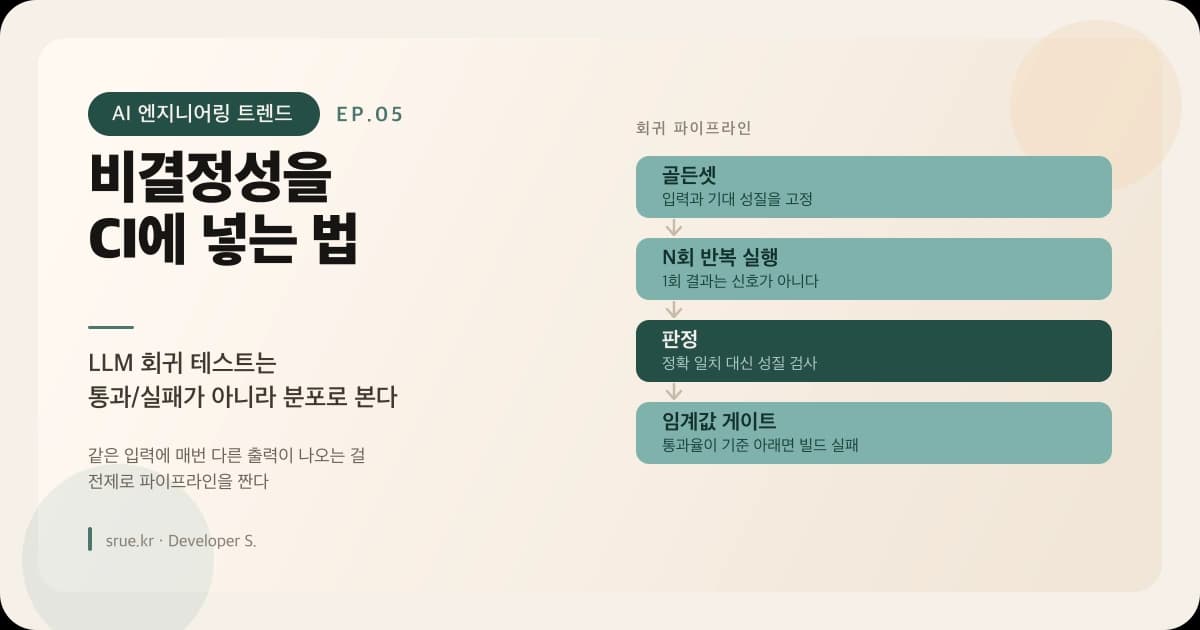
같은 입력에 매번 다른 답이 나오는 걸 전제로 테스트를 짰습니다. 정확 일치 대신 성질 검사, 1회 실행 대신 통과율 임계값으로 CI 게이트를 만든 과정을 정리했습니다.
TL;DR
- LLM 기능에 테스트를 안 붙이면, 프롬프트 한 줄 고칠 때마다 무엇이 깨졌는지 모릅니다.
- 정확 일치는 쓸 수 없습니다. 출력이 만족해야 할 성질을 검사합니다.
- 1회 실행 결과는 신호가 아닙니다. N회 돌려 통과율로 판단합니다.
- 게이트는 "전부 통과"가 아니라 "통과율이 기준 아래로 떨어졌는가"입니다.
코딩 에이전트를 고르는 기준을 정리하면서 "틀렸을 때 스스로 아는가"가 가장 중요하다고 썼습니다. 그런데 정작 제가 만든 LLM 기능에는 그런 장치가 없었습니다.
프롬프트를 한 줄 고치고 배포했는데, 며칠 뒤 다른 유형의 질문에서 답변 품질이 떨어졌다는 얘기를 들었습니다. 언제부터 그랬는지, 어떤 변경 때문인지 알 방법이 없었습니다.
일반 코드였다면 당연히 테스트가 있었을 겁니다. JWT 인증에도 테스트 케이스를 짰고 통합 테스트도 붙였는데, LLM 호출만 무방비였습니다.
이유는 단순했습니다. 뭘 단언해야 할지 몰랐습니다.
정확 일치가 안 되는 이유
처음엔 기대 출력을 박아두려 했습니다.
assertThat(response).isEqualTo("주문 20260922-0032는 배송 준비 중입니다.");한 번 돌리면 통과하고, 다시 돌리면 실패합니다. "주문번호 20260922-0032의 상태는 배송 준비 중입니다." 같은 게 나오니까요. 틀린 답이 아닌데 테스트는 빨갛습니다.
온도를 0으로 낮춰도 완전히 같아지지는 않았고, 모델 버전이 바뀌면 어차피 깨졌습니다.
그래서 방향을 바꿨습니다. 무엇이 같아야 하는지가 아니라, 무엇이 참이어야 하는지를 적기로 했습니다.
골든셋 — 입력과 "성질"을 고정한다
기대 문자열 대신 만족해야 할 성질을 적습니다.
record GoldenCase(
    String id,
    String input,
    List<String> mustContain,      // 반드시 포함해야 하는 사실
    List<String> mustNotContain,   // 나오면 안 되는 것 (환각·금칙어)
    String mustCallTool,           // 호출해야 할 도구 (없으면 null)
    int maxToolCalls               // 이 이상 호출하면 루프로 간주
) {}
실제 케이스는 이렇게 생겼습니다.
| 항목 | 값 |
|---|---|
input | "20260922-0032 주문 어떻게 됐어?" |
mustContain | ["20260922-0032", "배송"] |
mustNotContain | ["확인할 수 없습니다", "죄송"] |
mustCallTool | order.find |
maxToolCalls | 2 |
표현은 자유롭게 두되 사실은 고정합니다. 주문번호가 답변에 들어 있고, 조회 도구를 호출했고, 두 번 이상 헤매지 않았으면 통과입니다.
mustNotContain이 의외로 유용했습니다. "확인할 수 없습니다"가 나오면 실패로 두니, 도구가 망가졌을 때 바로 잡혔습니다. 조용히 회피하는 답변이 가장 발견하기 어려운 실패였거든요.
판정 단계 — 무엇을 무엇으로 검사할까
성질마다 검사 비용과 신뢰도가 다릅니다. 싼 것부터 순서대로 봅니다.
| 검사 | 방법 | 비용 | 신뢰도 |
|---|---|---|---|
| 사실 포함 | 문자열·정규식 | 0 | 높음 |
| 금칙어 | 문자열 | 0 | 높음 |
| 도구 호출 | 실행 로그 | 0 | 높음 |
| 스키마 준수 | JSON 파싱 | 0 | 높음 |
| 의미적 동등성 | 임베딩 유사도 | 낮음 | 중간 |
| 톤·유용성 | LLM 판정 | 높음 | 낮음 |
가능한 한 위쪽에서 끝내는 게 좋습니다. LLM으로 채점하는 건 마지막 수단입니다. 채점자도 흔들리기 때문에, 테스트의 불안정성을 줄이려다 불안정성을 하나 더 얹는 꼴이 됩니다.
LLM 판정을 쓸 때는 최소한 이렇게 했습니다.
- 이분 판정만 시킵니다. "1~5점"이 아니라 "이 답변이 주문 상태를 알려주는가: 예/아니오"
- 근거를 먼저 쓰게 합니다. 판정만 뽑으면 흔들립니다
- 판정도 여러 번 돌려 다수결로 봅니다
1회 실행은 신호가 아니다
가장 크게 바뀐 인식이 이겁니다.
일반 테스트는 한 번 통과하면 통과입니다. LLM은 아닙니다. 같은 케이스가 어떤 날은 되고 어떤 날은 안 됩니다. 한 번 실패했다고 롤백하면 멀쩡한 변경을 되돌리게 되고, 한 번 통과했다고 넘어가면 나빠진 걸 놓칩니다.
그래서 케이스마다 N회 돌리고 통과율을 기록합니다.
케이스 A : 10회 중 10회 통과  →  100%
케이스 B : 10회 중  9회 통과  →   90%
케이스 C : 10회 중  6회 통과  →   60%   ← 원래 90%였다면 회귀
판단은 절대 점수가 아니라 이전 대비로 합니다. 60%가 나쁜 건지는 그 케이스의 원래 통과율을 봐야 압니다.
CI 게이트
Actions에 넣을 때는 두 가지를 나눴습니다.
| 언제 | 무엇 | 실행 횟수 |
|---|---|---|
| PR마다 | 핵심 케이스 소수 (스모크) | 케이스당 3회 |
| 야간 스케줄 | 전체 골든셋 | 케이스당 10회 |
PR마다 전체를 10회씩 돌리면 시간도 비용도 감당이 안 됩니다. PR에서는 명백한 파손만 잡고, 통계적 회귀는 야간 배치에서 봅니다.
- name: LLM 스모크 테스트
  env:
    LLM_TEST_RUNS: 3
    LLM_TEST_SUITE: smoke
  run: ./gradlew test --tests '*LlmGoldenTest'

- name: 회귀 판정
  run: |
    # 케이스별 통과율이 기준선 대비 20%p 이상 떨어지면 실패
./gradlew llmRegressionCheck -PbaselineFile=baseline.json -PdropThreshold=0.2기준선(baseline.json)은 직전 성공 빌드의 통과율을 저장해 둔 것입니다. 배포 전 체크리스트를 만들 때와 같은 발상입니다 — 절대 기준이 아니라 직전 상태 대비 악화를 봅니다.
실제로 잡힌 것들
붙이고 나서 걸린 사례들입니다.
| 변경 | 잡힌 현상 |
|---|---|
| 시스템 프롬프트에 문장 한 줄 추가 | 특정 케이스 통과율 90% → 40% |
| 도구 설명 문구 수정 | 도구 호출 자체를 안 하기 시작 |
| 컨텍스트 압축 적용 | 주문번호가 요약에서 사라져 mustContain 실패 |
| 모델 버전 업 | 대부분 개선, 한 유형만 악화 |
마지막이 특히 값졌습니다. 모델을 올리면 전반적으로 좋아지지만 일부는 나빠집니다. 골든셋이 없으면 "전체적으로 좋아졌다"는 인상만 남고, 나빠진 쪽은 사용자가 발견합니다.
세 번째도 그렇습니다. EP.01에서 압축에 보존 목록을 넣은 건 이 테스트가 알려줘서였습니다.
정리
| 원칙 | 내용 |
|---|---|
| 무엇을 단언할까 | 정확 일치 ❌ → 만족해야 할 성질 |
| 몇 번 돌릴까 | 1회 ❌ → N회 통과율 |
| 어떻게 판정할까 | 싼 검사부터. LLM 채점은 최후 |
| 기준은 무엇 | 절대 점수 ❌ → 직전 대비 하락폭 |
| 어디서 돌릴까 | PR = 스모크 3회 / 야간 = 전체 10회 |
LLM 기능에 테스트가 없으면 프롬프트를 고칠 수 없습니다. 고칠 수는 있지만, 무엇이 좋아지고 무엇이 나빠졌는지 모른 채 고치게 됩니다. 그건 개선이 아니라 도박입니다.
다음 편
판정을 자동화하다 보니 출력 형식 자체를 강제하면 검사가 쉬워진다는 걸 알게 됐습니다. 그런데 스키마를 줬다고 스키마대로 오지는 않았습니다.
다음 편에서는 구조화 출력이 얼마나 믿을 만한가를 다룹니다.