
에이전트 관측성: 안 보이면 못 고친다는 원칙은 LLM 호출에도 그대로였다
에이전트가 왜 그렇게 답했는지 되짚을 수 없어 매번 추측으로 고쳤습니다. 스팬을 어떻게 나누고 무엇을 남겨야 실패를 재현할 수 있는지 정리했습니다.
TL;DR
- 에이전트 장애는 재현이 안 되는 게 본질입니다. 그 순간의 입력을 남기지 않으면 영영 모릅니다.
- 스팬은 요청 → 모델 호출 → 도구 호출 → 판정 네 층으로 나눕니다. 한 덩어리로 두면 어디서 샜는지 안 보입니다.
- 로그에 프롬프트 전문을 남기면 개인정보 문제가 생깁니다. 해시와 참조로 나눠 남깁니다.
- 가장 유용했던 지표는 응답 시간이 아니라 "도구를 몇 번 호출하고 끝냈는가"였습니다.
RAG를 걷어내고 구조를 바꾸는 동안 계속 불편했던 게 있습니다. 무엇이 좋아졌는지 확인할 방법이 부실했습니다.
"요즘 답변이 이상해요"라는 얘기를 들으면 재현부터 해야 하는데, 같은 질문을 던져도 잘 답합니다. 그 사용자의 그 순간 상태를 알 수가 없었습니다. 대화 이력이 몇 턴이었는지, 어떤 도구가 등록돼 있었는지, 검색이 뭘 가져왔는지 전부 휘발됐습니다.
분산 추적을 붙여둔 경험이 있는데도 LLM 호출만 블랙박스였습니다. HTTP 요청 하나로 뭉뚱그려져 있었으니까요.
한 덩어리로는 아무것도 안 보인다
처음 상태는 이랬습니다.
POST /api/assistant/ask 4,820ms 200여기서 알 수 있는 건 느렸다는 것뿐입니다. 모델이 느린 건지, 도구가 느린 건지, 도구를 여러 번 부른 건지 구분이 안 됩니다.
나눠야 보입니다.
POST /api/assistant/ask                    4,820ms
├─ agent.request        의도 분류·도구 등록      120ms
├─ llm.call #1          입력 4,180 · 출력 86     980ms
├─ tool.order.find      orderNo=...             240ms
├─ llm.call #2          입력 4,510 · 출력 62     890ms
├─ tool.order.find      orderNo=...  ← 같은 호출  230ms
├─ llm.call #3          입력 4,790 · 출력 210  2,140ms
└─ agent.decision       종료 · 도구 호출 2회
이렇게 놓고 보니 같은 도구를 두 번 불렀다는 게 바로 보입니다. EP.02에서 만든 연속 호출 상한이 왜 필요했는지도 여기서 확인됩니다.
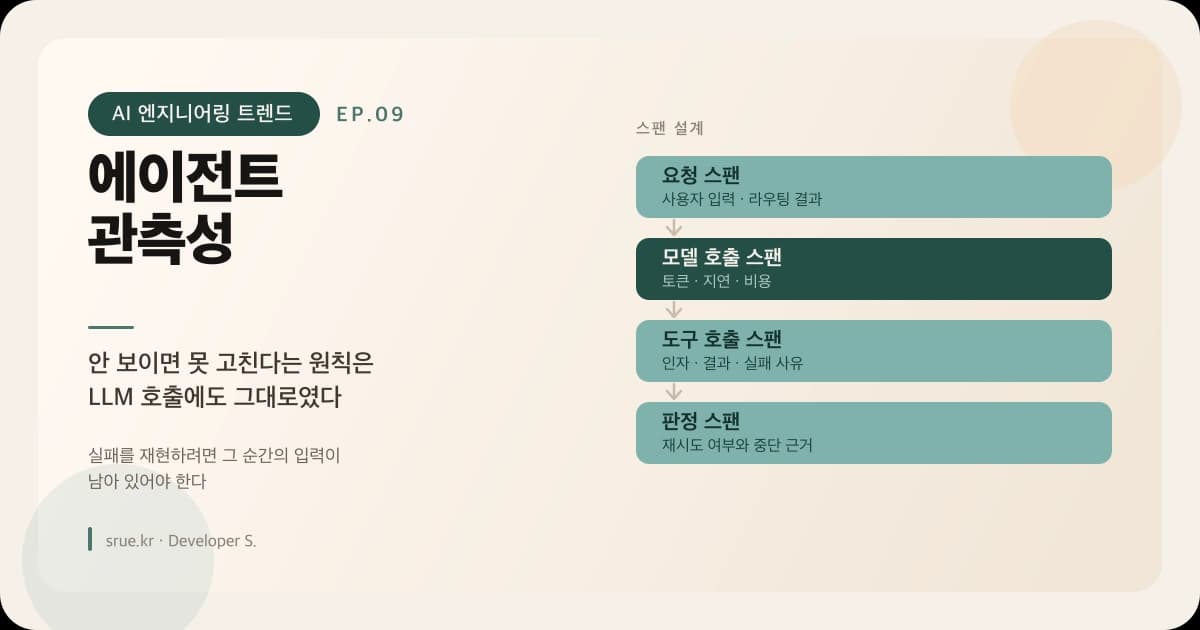
네 종류의 스팬
스팬을 이렇게 나눴습니다.
| 스팬 | 무엇을 남기나 |
|---|---|
| 요청 스팬 | 세션 ID, 의도 분류 결과, 등록된 도구 목록 |
| 모델 호출 스팬 | 입력·출력 토큰, 캐시 적중, 모델 버전, 지연, finish_reason |
| 도구 호출 스팬 | 도구 이름, 인자, 성공/실패, 실패 사유 |
| 판정 스팬 | 계속할지 멈출지, 그 근거, 총 호출 횟수 |
판정 스팬이 가장 늦게 추가했는데 가장 유용했습니다. 에이전트가 왜 멈췄는지(답을 찾아서? 상한에 걸려서? 포기해서?)가 기록으로 남으니, "이상하다"는 신고를 받았을 때 분류가 됩니다.
Spring AI 어드바이저로 붙였습니다. EP.01의 토큰 계측 어드바이저를 확장한 형태입니다.
@Component
public class TracingAdvisor implements CallAroundAdvisor {

    private final Tracer tracer;

    @Override
    public AdvisedResponse aroundCall(AdvisedRequest request, CallAroundAdvisorChain chain) {
        Span span = tracer.nextSpan().name("llm.call").start();

        try (Tracer.SpanInScope scope = tracer.withSpan(span)) {
            span.tag("llm.model", request.chatModel().toString());
            span.tag("llm.tools", String.valueOf(request.functionCallbacks().size()));
            // 프롬프트 전문 대신 해시. 같은 프롬프트인지 비교는 가능하되 내용은 안 남긴다.
            span.tag("llm.prompt.hash", sha256(request.userText()));

            AdvisedResponse response = chain.nextAroundCall(request);
            Usage usage = response.response().getMetadata().getUsage();

            span.tag("llm.tokens.in", String.valueOf(usage.getPromptTokens()));
            span.tag("llm.tokens.out", String.valueOf(usage.getGenerationTokens()));
            span.tag("llm.finish", finishReason(response));

            return response;
        } finally {
            span.end();
        }
    }
}
프롬프트를 그대로 남기면 안 된다
여기서 한 번 크게 걸렸습니다. 디버깅하겠다고 프롬프트 전문을 로그에 찍었는데, 거기에 사용자가 입력한 개인정보가 그대로 들어갔습니다.
운영 로그 구조를 정리할 때 세운 원칙을 그대로 적용했어야 했습니다. 다시 나눴습니다.
| 데이터 | 어디에 | 보존 |
|---|---|---|
| 프롬프트 해시 | 트레이스 태그 | 길게 |
| 토큰 수·지연·비용 | 메트릭 | 길게 |
| 도구 이름·성공 여부 | 트레이스 태그 | 길게 |
| 도구 인자 값 | 별도 저장소 · 접근 통제 | 짧게 |
| 프롬프트·응답 전문 | 별도 저장소 · 접근 통제 · 마스킹 | 짧게 |
해시만으로도 꽤 많은 게 됩니다. "이 실패들이 전부 같은 프롬프트에서 났나"를 확인할 수 있고, 프롬프트를 바꾼 시점도 해시 변화로 보입니다.
전문이 꼭 필요한 경우는 짧은 보존 기간을 두고 별도 저장소에 넣되, 트레이스 ID로 연결해 뒀습니다. 문제를 조사할 때만 그쪽을 열어봅니다.
실제로 본 지표들
대시보드에 올린 것 중 쓸모 순서입니다.
| 지표 | 왜 보는가 |
|---|---|
| 요청당 도구 호출 횟수 분포 | 꼬리가 길면 루프에 빠진 케이스가 있다는 뜻 |
| 종료 사유 비율 | 정상 종료 / 상한 도달 / 실패 비율 |
| 캐시 적중률 | EP.07 재배치 효과 |
| 도구별 실패율 | 특정 도구만 자주 깨지는지 |
| 입력 토큰 p95 | 컨텍스트 예산이 새고 있는지 |
| 응답 지연 p95 | 사용자 체감 |
첫 번째가 압도적으로 유용했습니다. 평균은 2회인데 p99가 8회면, 소수의 요청이 루프를 돌다 상한에 걸려 끝나고 있다는 뜻입니다. 그 요청들만 골라 트레이스를 열면 패턴이 보입니다.
응답 지연은 생각보다 덜 봤습니다. LLM 호출은 원래 느리고, 느린 것보다 헛도는 게 문제였습니다.
경보는 무엇에 걸까
처음엔 지연에 걸었다가 계속 울려서 다 껐습니다. 다시 잡은 기준입니다.
| 경보 | 조건 |
|---|---|
| 도구 호출 상한 도달 비율 급증 | 전일 대비 2배 이상 |
| 특정 도구 실패율 급증 | 10분 이동 평균이 임계 초과 |
| 파싱 실패율 급증 | EP.06 폴백 발동이 늘어남 |
| 입력 토큰 p95 급증 | 컨텍스트가 새는 중 |
| 비용 일일 총액 초과 | 사고 방지용 하드 리밋 |
"평소와 다른가"에 걸었지 절대값에 걸지 않았습니다. LLM 지표는 요청 성격에 따라 폭이 커서 절대 임계값이 잘 안 맞습니다. Sentry로 에러를 추적할 때와 같은 접근입니다.
정리
| 원칙 | 내용 |
|---|---|
| 나눠라 | 요청 · 모델 호출 · 도구 호출 · 판정 |
| 남겨라 | 판정 근거와 종료 사유. 가장 늦게 붙였는데 가장 쓸모 있었다 |
| 가려라 | 프롬프트는 해시로. 전문은 접근 통제된 곳에 짧게 |
| 봐라 | 지연보다 도구 호출 횟수 분포 |
| 걸어라 | 절대값 ❌ → 평소와 다른가 |
이 시리즈에서 계속 같은 말을 하고 있습니다. 안 보이면 못 고칩니다. 모델이 블랙박스라는 건 맞지만, 그 주변은 전부 우리가 계측할 수 있는 영역입니다.
다음 편
관측을 붙이고 비용 분포를 보니, 단순한 작업에까지 비싼 모델이 쓰이고 있었습니다. 전부 최고 모델로 돌리는 건 설계가 아니라 방치였습니다.
다음 편에서는 작은 모델이 이기는 구간을 다룹니다.