
코딩 에이전트, 벤치마크 말고 우리 코드베이스 기준으로 고르기
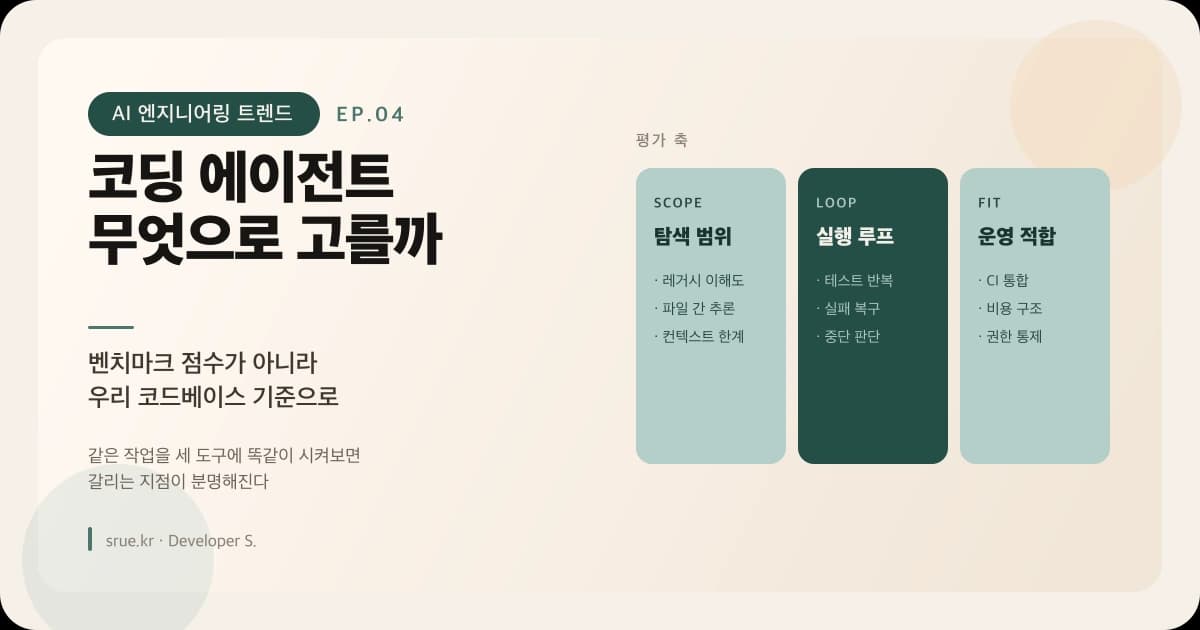
여러 코딩 에이전트를 실제 작업에 번갈아 쓰면서 갈리는 지점이 분명해졌습니다. 탐색 범위·실행 루프·운영 적합성 세 축으로 판단 기준을 정리했습니다.
TL;DR
- 벤치마크 점수는 우리 코드베이스에서의 성능을 예측하지 못했습니다. 갈리는 건 모델이 아니라 루프였습니다.
- 판단 축은 셋입니다 — 탐색 범위 · 실행 루프 · 운영 적합성.
- 가장 크게 갈린 건 "틀렸을 때 스스로 아는가"였습니다. 테스트를 돌려 확인하는 도구와 그냥 끝났다고 하는 도구의 차이가 컸습니다.
- 하나만 쓰지 않아도 됩니다. 작업 유형별로 나눠 쓰는 게 실제로 가장 잘 맞았습니다.
예전에 코딩 도구를 비교한 적이 있습니다. 그때는 "자동완성이 얼마나 정확한가" 수준의 이야기였습니다.
지금은 상황이 다릅니다. 도구가 파일을 열고, 고치고, 테스트를 돌리고, 실패하면 다시 고칩니다. 비교할 대상이 완성 정확도가 아니라 일하는 방식이 됐습니다.
몇 달 번갈아 쓰면서, 벤치마크 순위와 제 체감이 자꾸 어긋났습니다. 왜 그런지 따져보니 기준이 잘못돼 있었습니다.
벤치마크가 예측하지 못하는 것
공개 벤치마크는 대체로 잘 정의된 문제를 풉니다. 요구사항이 명확하고, 파일이 적고, 정답이 있습니다.
제 실무는 그렇지 않았습니다.
| 벤치마크 | 실무 |
|---|---|
| 문제가 명확히 서술됨 | "결제가 가끔 두 번 찍힌대요" |
| 파일 1~3개 | 모듈 5개에 걸쳐 있음 |
| 정답이 존재 | 트레이드오프만 존재 |
| 문맥이 자족적 | 3년 전 결정의 이유를 알아야 함 |
| 실패해도 무해 | 되돌릴 수 없는 것이 섞임 |
이 간극에서 도구가 갈렸습니다. 벤치마크에서 앞서던 게 레거시 코드 앞에서 헤매고, 순위가 낮던 게 꾸준히 일을 끝냈습니다.
축 1 — 탐색 범위
첫 번째 기준은 "고칠 곳을 스스로 찾아내는가"입니다.
같은 요청("주문 취소 시 재고가 복원되지 않는 버그를 찾아 고쳐라")을 던져보면 행동이 갈립니다.
| 행동 | 판정 |
|---|---|
| 이름이 비슷한 파일만 열어보고 추측 | ❌ 범위가 좁음 |
| 호출 관계를 타고 올라가 원인 지점을 특정 | ✅ |
| 관련 테스트를 먼저 찾아 현재 동작을 파악 | ✅ 좋음 |
| 파일을 너무 많이 열어 컨텍스트를 태움 | ⚠️ 예산 관리 실패 |
마지막이 함정입니다. 많이 읽는 게 잘 읽는 게 아닙니다. 40개 파일을 읽고 컨텍스트가 가득 차 정작 수정 단계에서 앞을 잊는 경우를 여러 번 봤습니다.
좋은 도구는 읽을 것과 안 읽을 것을 구분했습니다. 이건 모델 크기보다 도구의 검색 전략에 달린 문제였습니다.
축 2 — 실행 루프
가장 크게 갈린 축입니다. "틀렸을 때 스스로 아는가."
좋은 루프
  수정 → 테스트 실행 → 실패 확인 → 원인 수정 → 재실행 → 통과 → 종료

나쁜 루프
  수정 → "완료했습니다" → (실제로는 컴파일도 안 됨)
차이를 만드는 건 검증 수단에 접근할 수 있는가입니다. 테스트를 돌릴 수 있는 도구는 자기 실수를 발견합니다. 못 돌리는 도구는 그럴듯한 코드를 내놓고 끝냅니다.
그래서 저는 이걸 봅니다.
| 점검 | 왜 중요한가 |
|---|---|
| 테스트를 스스로 실행하는가 | 시키지 않아도 돌려야 의미 있음 |
| 실패 로그를 읽고 원인을 바꾸는가 | 같은 수정을 반복하면 무한루프 |
| 몇 번 실패하면 멈추는가 | 상한이 없으면 토큰만 태웁니다 |
| 못 하겠으면 못 하겠다고 하는가 | 가장 과소평가된 능력 |
마지막 항목을 강조하고 싶습니다. "이 부분은 제가 판단할 수 없습니다"라고 말하는 도구가 훨씬 쓸 만했습니다. 확신에 찬 오답보다 정직한 보류가 낫습니다.
Testcontainers로 통합 테스트를 정리해둔 게 여기서 예상 밖의 값을 했습니다. 에이전트가 실제 DB에 붙는 테스트를 돌릴 수 있으니, 추측 대신 확인을 했습니다.
축 3 — 운영 적합성
혼자 쓸 때는 안 보이다가 팀에 넣으면 보이는 것들입니다.
| 항목 | 확인할 것 |
|---|---|
| CI 통합 | 헤드리스 실행이 되는가, 종료 코드가 정확한가 |
| 권한 통제 | 어디까지 건드릴 수 있는지 제한이 가능한가 |
| 변경 범위 | 시키지 않은 파일을 고치지 않는가 |
| 비용 구조 | 호출당인가 정액인가, 실패한 시도도 과금되는가 |
| 재현성 | 같은 지시에 비슷한 결과가 나오는가 |
"시키지 않은 파일을 고치지 않는가"가 실전에서 가장 중요했습니다. 버그 하나 고쳐달라고 했는데 포맷팅이 12개 파일에 걸쳐 바뀌면, diff를 읽을 수가 없습니다. 리뷰가 불가능한 변경은 없느니만 못합니다.
PR 자동 리뷰를 붙일 때도 같은 문제를 겪었습니다. 범위를 좁히지 않으면 결과물이 신뢰를 잃습니다.
하나만 고르지 않아도 된다
몇 달 써보고 내린 결론은 "작업 유형별로 나눠 쓴다"였습니다.
| 작업 | 필요한 성질 |
|---|---|
| 넓은 탐색 · 원인 규명 | 탐색 범위 + 긴 컨텍스트 |
| 반복적 수정 · 마이그레이션 | 빠른 루프 + 낮은 비용 |
| 설계 논의 · 트레이드오프 | 추론 품질. 코드를 안 써도 됨 |
| CI 안에서 자동 검사 | 헤드리스 + 종료 코드 + 예측 가능성 |
한 도구가 넷을 다 잘할 이유가 없습니다. 비용 구조도 다릅니다 — 반복 수정에 최고급 모델을 쓰는 건 소형 모델 편에서 다룰 이야기처럼 설계가 아니라 방치에 가깝습니다.
직접 해보는 평가 방법
벤치마크 대신 이렇게 재봅니다. 한 시간이면 됩니다.
1. 우리 저장소에서 이미 고쳐진 버그 3개를 고른다
   (정답을 알고 있으니 채점이 가능하다)
2. 해당 커밋 직전 상태로 체크아웃한다
3. 이슈 제목만 주고 고치라고 시킨다
4. 다음을 기록한다
   · 원인 지점을 찾았는가
   · 테스트를 스스로 돌렸는가
   · 시키지 않은 파일을 건드렸는가
   · 몇 번 만에 끝냈는가 / 포기했는가
이미 고쳐진 버그를 쓰는 게 핵심입니다. 정답 커밋이 있으니 비교가 명확하고, 우리 코드베이스의 난이도가 그대로 반영됩니다. 공개 벤치마크에 없는 조건입니다.
정리
| 축 | 한 줄 |
|---|---|
| 탐색 범위 | 많이 읽는 게 아니라 읽을 것을 고르는 능력 |
| 실행 루프 | 틀렸을 때 스스로 아는가. 여기서 가장 크게 갈림 |
| 운영 적합성 | 범위를 지키는가, CI에 넣을 수 있는가 |
그리고 도구가 바뀌어도 남는 건 하네스 쪽이었습니다. 테스트가 잘 갖춰져 있고, 권한 경계가 분명하고, 변경 범위를 강제할 수 있으면 어떤 도구를 써도 결과가 괜찮았습니다. 반대면 어떤 도구를 써도 비슷하게 헤맸습니다.
EP.02에서 내린 결론이 여기서도 그대로였습니다 — 성능을 만드는 건 모델이 아니라 그 주변 구조입니다.
다음 편
도구를 골랐으면 이제 그 결과를 믿을 수 있는지 확인할 차례입니다. 같은 입력에 매번 다른 출력이 나오는 걸 어떻게 테스트할까요.
다음 편에서는 LLM 회귀 테스트를 CI에 넣는 법을 다룹니다.