
작은 모델이 이기는 구간: 모든 요청에 최고 모델을 쓰는 건 설계가 아니다
관측 지표를 보니 분류와 추출 같은 단순 작업에까지 가장 비싼 모델이 쓰이고 있었습니다. 작업 유형별로 모델을 나누고 라우팅을 붙인 과정을 정리했습니다.
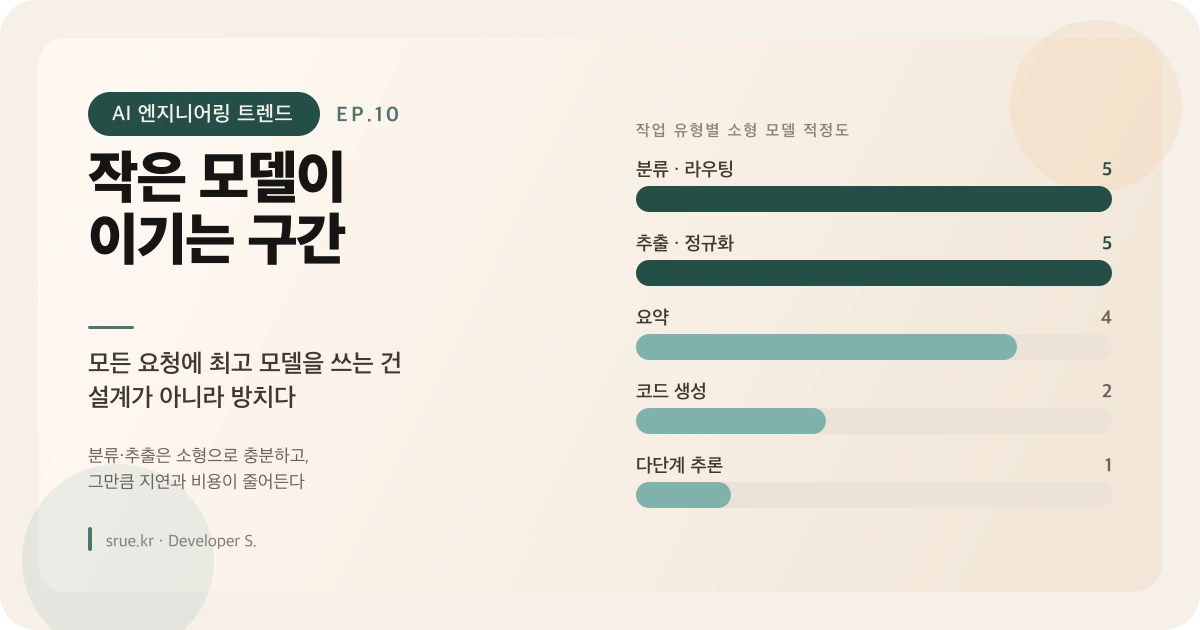
TL;DR
- 분류·추출·정규화는 소형 모델로 충분했습니다. 여기에 최고 모델을 쓰는 건 낭비입니다.
- 소형 모델의 이득은 비용만이 아닙니다. 지연이 줄어드는 게 체감상 더 컸습니다.
- 라우팅 자체를 LLM에게 시키면 배보다 배꼽이 커집니다. 규칙으로 가르는 편이 낫습니다.
- 기준은 감이 아니라 골든셋 통과율입니다. 바꿔보고 재보면 됩니다.
관측을 붙이고 요청 유형별 비용 분포를 봤습니다. 예상과 달랐습니다.
가장 많이 호출되는 건 의도 분류였습니다. 사용자 입력이 조회인지 취소인지 문의인지 가르는 단계인데, EP.02에서 도구를 동적 등록하려고 넣어둔 것이었습니다.
그런데 이 단계에도 가장 비싼 모델이 쓰이고 있었습니다. 기본값으로 두고 따로 지정하지 않았으니까요.
왜 전부 최고 모델을 쓰고 있었나
이유는 단순했습니다. 그렇게 하는 게 안전해 보여서입니다.
처음 만들 때는 품질이 불확실하니 가장 좋은 걸 씁니다. 돌아가면 그대로 둡니다. 굳이 내릴 이유를 못 찾습니다. 그러다 호출량이 늘면 비용이 따라 늡니다.
그런데 따져보니 작업마다 필요한 능력이 전혀 달랐습니다.
| 작업 | 실제로 필요한 것 |
|---|---|
| 의도 분류 | 정해진 몇 개 중 하나 고르기 |
| 필드 추출 | 문장에서 날짜·번호 뽑기 |
| 정규화 | 표현을 표준 형식으로 |
| 요약 | 길이 줄이면서 사실 보존 |
| 코드 생성 | 문법 + 문맥 추론 |
| 다단계 추론 | 계획 · 자기 수정 |
위 세 개는 고르기와 뽑기입니다. 창의성도 추론도 필요 없습니다. 그런데 저는 다단계 추론용 모델로 그걸 하고 있었습니다.
바꿔보고 재봤다
감으로 정하지 않고 EP.05의 골든셋을 그대로 썼습니다. 모델만 바꿔 통과율을 비교했습니다.
| 작업 | 소형 모델 결과 |
|---|---|
| 의도 분류 | 통과율 차이 없음 |
| 필드 추출 (날짜·주문번호) | 통과율 차이 없음 |
| 정규화 | 통과율 차이 없음 |
| 요약 | 약간 하락 — 보존 목록을 명시하니 회복 |
| 코드 생성 | 뚜렷하게 하락 |
| 다단계 추론 | 사용 불가 수준 |
위 세 개가 차이가 없다는 게 핵심입니다. 테스트가 있었기 때문에 자신 있게 내릴 수 있었습니다. 골든셋이 없었다면 "혹시 나빠질까 봐" 못 바꿨을 겁니다.
요약이 흥미로웠습니다. 그냥 요약시키면 소형 모델이 세부를 더 많이 버렸는데, EP.01에서 만든 보존 목록(식별자·숫자·고유명사는 원문 유지)을 프롬프트에 넣으니 차이가 사라졌습니다. 지시를 정확히 주면 작은 모델도 따라옵니다.
비용보다 지연이 더 체감됐다
기대한 건 비용 절감이었는데, 실제로 더 크게 느껴진 건 응답 속도였습니다.
의도 분류는 사용자 입력 직후에 실행됩니다. 여기가 느리면 첫 반응까지의 시간이 통째로 늘어납니다. 소형 모델로 바꾸니 이 구간이 눈에 띄게 짧아졌고, 체감 반응성이 달라졌습니다.
변경 전:  [입력] → 분류(대형) → 도구 선택 → 본 호출(대형) → 응답
변경 후:  [입력] → 분류(소형) → 도구 선택 → 본 호출(대형) → 응답
                    ↑ 여기가 짧아지면 첫 반응이 빨라진다
사용자는 총 시간보다 "반응이 시작되기까지"를 더 예민하게 느낍니다. 앞단을 가볍게 하는 게 뒤를 최적화하는 것보다 효과적이었습니다.
라우팅을 LLM에게 시키지 마라
한 번 잘못 간 길이 있습니다. "어떤 모델을 쓸지도 LLM이 판단하게 하자"는 아이디어였습니다.
배보다 배꼽이 컸습니다. 라우팅 판단에 또 한 번 호출이 들어가니, 절감한 비용을 라우터가 까먹었습니다. 게다가 라우터가 가끔 틀려서 단순 작업에 대형 모델을 배정했습니다.
규칙으로 바꿨습니다.
public ChatModel select(TaskType type, TaskContext context) {
    return switch (type) {
        case CLASSIFY, EXTRACT, NORMALIZE -> smallModel;
        case SUMMARIZE -> context.inputTokens() > 8_000 ? largeModel : smallModel;
        case CODE, PLAN, REASON -> largeModel;
    };
}TaskType은 이미 알고 있는 값입니다. 어느 코드 경로에서 호출하는지 우리가 알고 있으니, 모델에게 물어볼 이유가 없었습니다. 판단 비용 0, 정확도 100%.
EP.02에서 내린 결론과 같습니다 — 코드가 판단할 수 있는 건 코드가 합니다. 에이전트에게 넘길 이유가 없습니다.
자체 호스팅은 계산이 다르다
"소형 모델이면 직접 돌리는 게 싸지 않나" 하는 생각도 해봤는데, 계산해보니 간단치 않았습니다.
| API 호출 | 자체 호스팅 | |
|---|---|---|
| 초기 비용 | 없음 | GPU 인스턴스 |
| 단가 | 토큰당 | 유휴 시간에도 과금 |
| 운영 | 없음 | 모델 서빙·업데이트·장애 대응 |
| 지연 | 네트워크 홉 | 낮음 (같은 VPC) |
| 손익분기 | — | 호출량이 꾸준히 많을 때만 |
핵심은 유휴 시간입니다. 트래픽이 낮 시간에 몰리고 밤에는 거의 없는데, GPU는 24시간 켜져 있습니다. 저희 호출량에서는 API가 쌌습니다.
다만 지연이 정말 중요한 경로나, 데이터를 외부로 내보낼 수 없는 경우라면 계산이 달라집니다. 비용만으로 결정할 문제는 아닙니다.
정리
| 작업 | 모델 | 근거 |
|---|---|---|
| 분류 · 추출 · 정규화 | 소형 | 골든셋 통과율 차이 없음 |
| 요약 | 소형 + 보존 목록 명시 | 지시를 정확히 주면 따라옴 |
| 코드 생성 · 다단계 추론 | 대형 | 뚜렷한 품질 차이 |
| 라우팅 판단 | 모델 아님. 코드 | 이미 알고 있는 값 |
그리고 이 결정을 할 수 있었던 건 테스트가 있었기 때문입니다. 통과율을 재볼 수 없으면 모델을 내리는 건 도박이 됩니다. 그래서 아무도 안 내리고, 비용은 계속 늘어납니다.
측정할 수 있으면 줄일 수 있습니다.
다음 편
모델과 비용을 정리하고 나서, 이 시리즈에서 다룬 것들을 실제 개발 흐름에 넣어봤습니다. 가장 먼저 붙인 게 코드 리뷰였는데, 오탐 때문에 한동안 아무도 읽지 않았습니다.
다음 편에서는 AI 코드 리뷰를 쓸 만하게 만드는 법을 다룹니다.